
Siete Señales de que tu Sistema de Software Está Mal Documentado
La documentación deficiente rara vez se manifiesta como un simple README faltante. Se hace evidente a través de un onboarding lento, lanzamientos riesgosos, preguntas repetidas e incidentes que solo una persona sabe resolver.
Estas siete señales pueden ayudar a los líderes de ingeniería a identificar la deuda de documentación y decidir qué corregir primero.
1. Solo una persona puede explicar los flujos críticos
Un equipo de ingeniería saludable debería poder explicar cómo se mueven por el sistema los flujos de trabajo importantes, tanto de usuario como operativos.
Cuando solo un desarrollador entiende cómo un pedido se convierte en un pago, cómo un archivo llega a su almacenamiento de largo plazo, o cómo se aprovisiona una cuenta, el sistema depende del conocimiento tribal. El conocimiento tribal es información operativa almacenada principalmente en la memoria de las personas en lugar de en una fuente accesible.
El documento faltante generalmente no es un README más largo. Suele ser un diagrama de flujo que muestre el punto de entrada, los servicios, los almacenes de datos, los pasos asíncronos, los estados de falla y las dependencias externas.
2. No se puede confiar en los diagramas de arquitectura
Un diagrama desactualizado puede ser peor que no tener ningún diagrama, porque genera una falsa confianza.
Las señales de alerta incluyen diagramas que contienen servicios que ya no existen, colas o integraciones faltantes, límites de red incorrectos, y ninguna indicación de qué entorno representan.
Un diagrama de arquitectura útil debe tener un alcance claro, un responsable y una fecha de última revisión visible. Debe mostrar relaciones significativas en lugar de cada recurso cloud existente.
3. Los ingenieros preguntan repetidamente lo mismo
Las preguntas son normales. Las preguntas repetidas sobre los mismos temas básicos indican que el conocimiento no se está capturando donde los ingenieros trabajan.
Ejemplos típicos incluyen:
- ¿Qué repositorio es dueño de este servicio?
- ¿Cómo lo ejecuto localmente?
- ¿Qué variable de entorno controla este comportamiento?
- ¿Quién es responsable del pipeline de despliegue?
- ¿Qué sucede cuando esta cola falla?
Busca en Slack, notas de incidentes, pull requests y canales de soporte preguntas recurrentes. Son evidencia directa de dónde la documentación reduciría la fricción.
4. Los lanzamientos dependen de pasos manuales sin documentar
Un proceso de despliegue está mal documentado cuando el éxito depende de recordar comandos, cambiar configuración en un orden específico, o contactar a la persona que normalmente se encarga de los lanzamientos.
El riesgo es mayor cuando los pasos manuales afectan migraciones de bases de datos, secretos, DNS, feature flags o procedimientos de rollback.
Documenta la secuencia de lanzamiento, los prerrequisitos, las validaciones, la ruta de rollback y la responsabilidad de cada paso. Mejor aún, automatiza los pasos repetibles a través de un pipeline de despliegue. La documentación debe explicar el proceso y sus excepciones; no debe reemplazar la automatización.
5. Los incidentes requieren reconstruir la arquitectura
Durante un incidente, el equipo no debería necesitar redescubrir el sistema antes de investigar la falla.
Cuando los responsables deben primero determinar qué servicio llama a qué base de datos, dónde se almacenan los logs, o quién es dueño de una integración externa, el sistema carece de documentación operativa.
Las cargas de trabajo críticas necesitan un runbook. Un runbook es un procedimiento práctico para diagnosticar y manejar un problema operativo. Debe incluir dashboards, ubicaciones de logs, modos de falla probables, pasos de mitigación seguros, contactos de escalamiento y verificaciones de recuperación.
6. Los cambios producen efectos secundarios inesperados
Los efectos secundarios inesperados suelen revelar dependencias sin documentar.
Un equipo modifica un campo de estado de cliente y rompe la facturación. Un mensaje de cola incorpora una nueva propiedad y hace fallar a un consumidor antiguo. Se modifica una tabla compartida de base de datos sin saber que otro servicio la lee directamente.
Estas son brechas de documentación de arquitectura y de contratos. El equipo puede necesitar un mapa de dependencias, contratos de API o de eventos, y una propiedad clara de los datos compartidos. Las pruebas automatizadas siguen siendo esenciales, pero por sí solas no explican por qué existe una dependencia ni quién puede modificarla.
7. El onboarding requiere guía en vivo constante
Los nuevos ingenieros no deberían necesitar interrumpir a varias personas solo para compilar, ejecutar y entender el sistema.
Un camino de onboarding práctico debe explicar la estructura del repositorio, la configuración local, el modelo de despliegue, las decisiones arquitectónicas importantes, los flujos de trabajo relevantes y tareas iniciales seguras.
La guía en vivo sigue siendo útil. El problema es usar reuniones para comunicar la misma información de configuración y arquitectura cada vez que alguien se incorpora.
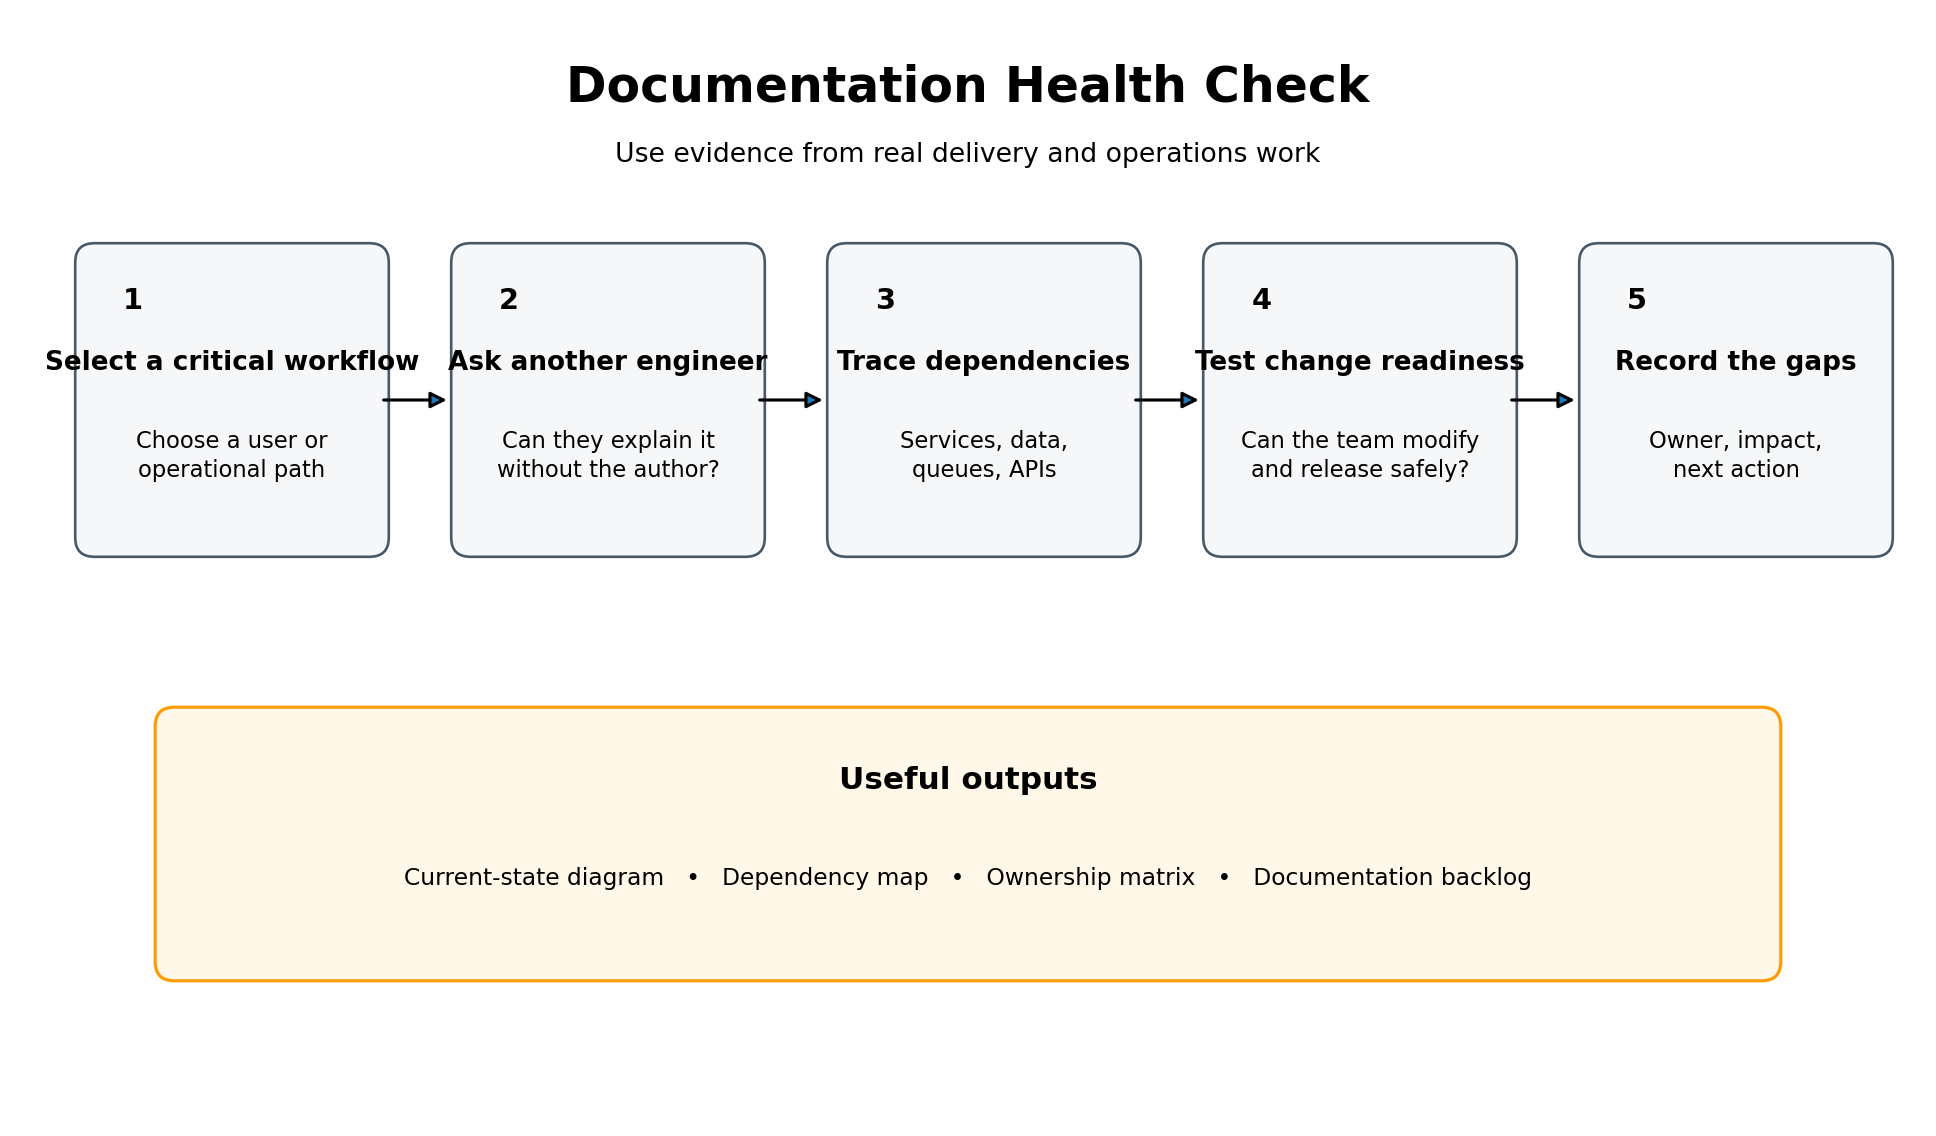
Una verificación práctica del estado de la documentación
No empieces por intentar documentar toda la plataforma. Comienza con un flujo de trabajo crítico:
- Selecciona un proceso importante, de usuario u operativo.
- Pide a un ingeniero que no lo haya construido que explique el recorrido.
- Traza los repositorios, servicios, almacenes de datos, colas y sistemas externos involucrados.
- Verifica si el equipo puede cambiar, desplegar, monitorear y recuperar el flujo de forma segura.
- Registra cada brecha de conocimiento con un responsable, un impacto y una siguiente acción.
El resultado puede incluir un diagrama del estado actual, un mapa de dependencias, un runbook, un inventario de APIs, una matriz de responsabilidades o una guía de despliegue. Prioriza los artefactos que reducen el riesgo de entrega u operativo.
Ejemplo: un flujo de procesamiento de archivos sin documentar
Considera un sistema donde los usuarios suben documentos de cumplimiento a Amazon S3. Un evento de S3 invoca AWS Lambda, que extrae metadatos, escribe el estado en DynamoDB y envía un mensaje a Amazon SQS para el escaneo antivirus.
Los escaneos fallidos eventualmente llegan a una cola de mensajes fallidos (dead-letter queue), pero solo el desarrollador original lo sabe. Una dead-letter queue almacena mensajes que no pudieron procesarse después de varios intentos.
Cuando ese desarrollador no está disponible, el equipo ve documentos atascados en “procesando” pero no sabe dónde investigar. Un diagrama de flujo, una alerta para la dead-letter queue y un runbook de recuperación resolverían la brecha de forma mucho más efectiva que un documento de arquitectura general extenso.
Compensaciones y errores comunes
La principal compensación es el costo de mantenimiento. Cada documento crea otro artefacto que puede volverse obsoleto.
Evita documentar manualmente detalles que ya son claros en el código o que pueden generarse automáticamente. Enfoca la documentación en el contexto: por qué se tomó una decisión, cómo interactúan los componentes, qué puede fallar, quién es dueño del sistema y cómo operarlo de forma segura.
Otro error común es medir la documentación por cantidad de páginas. Diez páginas precisas vinculadas a flujos críticos son más útiles que una wiki extensa en la que nadie confía.
Conclusión
La documentación deficiente se hace visible en cómo trabaja el equipo: preguntas repetidas, lanzamientos frágiles, dependencias poco claras, respuesta lenta a incidentes y dependencia de personas específicas.
Comienza con un flujo de trabajo crítico. Confirma que otro ingeniero pueda entenderlo, modificarlo, desplegarlo y recuperarlo usando la documentación disponible, y luego convierte las brechas en un backlog priorizado.