
Reconstrucción de una Arquitectura Serverless SaaS
Una aplicación SaaS serverless puede ser difícil de entender cuando su documentación está incompleta, desactualizada, o dispersa entre repositorios y cuentas de AWS. La reconstrucción de arquitectura convierte la evidencia técnica disponible en un modelo confiable de cómo funciona realmente la aplicación.
El objetivo no es producir un diagrama decorativo. Es crear un mapa operativo que los ingenieros puedan usar para evaluar riesgos, planificar cambios, investigar fallas y transferir conocimiento.
Qué significa la reconstrucción de arquitectura
La reconstrucción de arquitectura es el proceso de descubrir un sistema a partir de su implementación y su comportamiento en tiempo de ejecución.
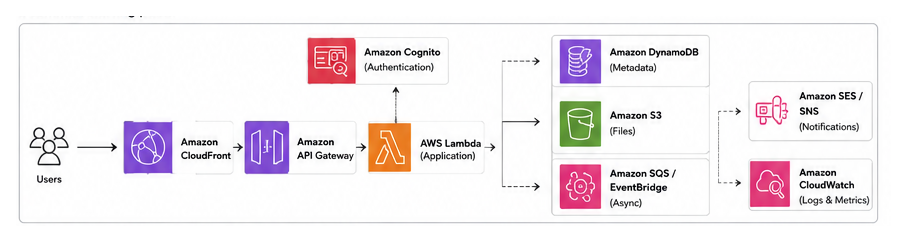
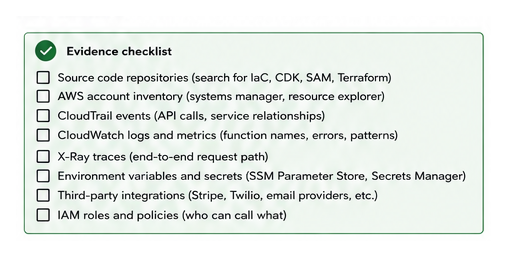
Para una aplicación serverless en AWS, la evidencia normalmente incluye:
- Infrastructure as code, como AWS CDK, CloudFormation, SAM o Terraform.
- Código fuente de Lambda y configuración de despliegue.
- Rutas e integraciones de API Gateway.
- Reglas de EventBridge, colas SQS, tópicos SNS y tareas programadas.
- Tablas de DynamoDB, buckets de S3 y bases de datos relacionales.
- Roles de IAM, políticas, secretos y variables de entorno.
- Logs, métricas, trazas y alarmas de CloudWatch.
- Integraciones externas como Stripe, Twilio o proveedores de correo electrónico.
El resultado debe explicar tanto la estructura como el comportamiento. La estructura identifica los componentes. El comportamiento explica cómo se mueven las solicitudes, los eventos, los datos y las fallas a través de ellos.
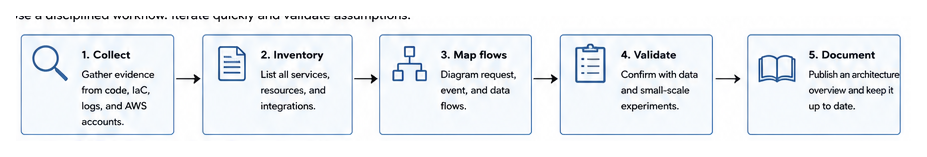
Un flujo de trabajo práctico de reconstrucción
No empieces dibujando cada recurso de AWS. Comienza con una capacidad de negocio y trázala desde el punto de entrada hasta el resultado final.
1. Establece el límite del sistema
Define qué pertenece a la aplicación y qué es externo.
Registra los clientes orientados al usuario, las APIs públicas, las interfaces administrativas, las cuentas de AWS, los entornos, los servicios de terceros y los principales almacenes de datos. Esto evita que la reconstrucción se expanda hacia infraestructura no relacionada.
2. Construye un inventario de recursos
Exporta o inspecciona los recursos desplegados y compáralos con el código de infraestructura.
Agrupa los recursos por responsabilidad en lugar de por servicio de AWS. Por ejemplo:
- Autenticación y acceso de tenants.
- Procesamiento de reservas o transacciones.
- Notificaciones.
- Reportes.
- Almacenamiento de archivos.
- Procesamiento en segundo plano.
- Monitoreo operativo.
Esta agrupación es más útil que una lista larga de funciones Lambda y colas.
3. Traza los flujos de trabajo críticos
Selecciona entre tres y cinco flujos de trabajo que importen para el negocio. Para cada flujo, registra:
- Punto de entrada.
- Verificaciones de autenticación y autorización.
- Llamadas síncronas.
- Eventos o mensajes en cola.
- Lecturas y escrituras de datos.
- Integraciones externas.
- Comportamiento esperado ante fallas.
- Logs y métricas disponibles para el diagnóstico.
Un diagrama de secuencia suele ser más valioso aquí que otro diagrama de infraestructura.
4. Valida los supuestos con evidencia en tiempo de ejecución
El código revela el comportamiento previsto. Los logs y las trazas revelan el comportamiento real.
Usa CloudWatch Logs, AWS X-Ray, CloudTrail, los logs de acceso de API Gateway y las métricas de colas para verificar las rutas que has documentado. Cuando no haya evidencia disponible, marca la relación como un supuesto en lugar de presentarla como un hecho.
5. Produce un conjunto pequeño de documentos mantenibles
Un paquete inicial útil normalmente incluye:
- Diagrama de contexto del sistema.
- Diagrama a nivel de contenedores o servicios.
- Diagramas de flujos de trabajo críticos.
- Inventario de APIs y eventos.
- Mapa de propiedad de los almacenes de datos.
- Flujo de autenticación y autorización.
- Arquitectura de despliegue.
- Riesgos, incógnitas y preguntas de seguimiento.
Mantén los archivos fuente de los diagramas en el repositorio. Las imágenes generadas por sí solas son difíciles de mantener.
Ejemplo: reconstrucción de un flujo de reserva de citas
Supongamos una plataforma SaaS que permite a los clientes reservar citas con pequeños negocios.
La aplicación web pública llama a un endpoint de API Gateway. El endpoint invoca una función Lambda que valida el tenant, lee la disponibilidad del servicio desde DynamoDB, y crea la cita. La función luego publica un evento en EventBridge.
Un suscriptor envía una confirmación a través de un proveedor externo de mensajería. Otro actualiza los datos de reportes. Una Lambda programada envía recordatorios más adelante.
El diagrama inicial puede sugerir un flujo simple de solicitud-respuesta. La investigación en tiempo de ejecución puede revelar que las fallas de notificación se reintentan a través de SQS y que se permite que el suscriptor de reportes falle sin afectar la reserva.
Esa distinción importa. Identifica qué operaciones son parte de la transacción crítica y cuáles son eventualmente consistentes. La consistencia eventual significa que los datos dependientes pueden actualizarse después de que finaliza la solicitud original, en lugar de dentro de la misma transacción.
Compensaciones y errores comunes
Documentar recursos en lugar de responsabilidades
Un diagrama que contiene cada función Lambda, rol de IAM, grupo de logs y cola rápidamente se vuelve ilegible. Usa múltiples vistas: una vista general simple del sistema, diagramas de flujo enfocados, y un inventario de recursos detallado.
Tratar el código de infraestructura como la verdad completa
El código de infraestructura puede no incluir recursos creados manualmente, configuración externa, feature flags en tiempo de ejecución, o recursos desplegados por otro pipeline. Compara la infraestructura declarada con el entorno realmente desplegado.
Dibujar flechas sin verificar
Una flecha implica una dependencia real. Verifícala mediante código, configuración, logs, trazas o metadatos de servicios de AWS. Marca explícitamente las rutas inciertas.
Ignorar el comportamiento asíncrono
Los sistemas serverless suelen depender de colas, eventos, reintentos, dead-letter queues y tareas programadas. Omitirlos oculta los modos de falla y hace que la arquitectura parezca más síncrona de lo que realmente es.
Perseguir una completitud perfecta
La reconstrucción tiene rendimientos decrecientes. Un mapa de flujos críticos que respalde un cambio próximo es más valioso que un catálogo completo que llega demasiado tarde. Prioriza las áreas con mayor riesgo operativo o de entrega.
Conclusión
Una arquitectura reconstruida debe explicar cómo la aplicación SaaS entrega sus capacidades más importantes, hacia dónde se mueven los datos, y cómo se manejan las fallas. Comienza con evidencia desplegada, valida los flujos críticos, y registra las incógnitas en lugar de suponer.
Elige un flujo de trabajo en producción esta semana y trázalo desde la acción del usuario hasta su efecto secundario final. Ese único ejercicio suele revelar los próximos diagramas, inventarios y preguntas operativas que vale la pena documentar.