
Qué Debe Incluir una Evaluación de Arquitectura AWS
Una evaluación de arquitectura AWS debe ser más que comparar un sistema contra una lista de buenas prácticas cloud. Debe explicar cómo funciona el sistema, identificar riesgos materiales y darle al equipo un plan de mejora realista.
Una evaluación útil conecta los hallazgos técnicos con consecuencias operativas y de negocio: interrupciones de servicio, exposición de seguridad, aumento de costos, entregas lentas o dependencia excesiva de desarrolladores específicos.
Comienza con el alcance y el contexto de negocio
Antes de revisar los servicios de AWS, define qué se va a evaluar.
Una plataforma puede contener docenas de cuentas, aplicaciones, pipelines e integraciones con terceros. Revisar todo con la misma profundidad generalmente genera ruido en lugar de conclusiones útiles.
La evaluación debe identificar:
- Cargas de trabajo y recorridos de usuario críticos
- Requisitos de negocio y regulatorios
- Expectativas de recuperación
- Incidentes conocidos o problemas recurrentes
- Crecimiento esperado o cambios arquitectónicos
- Restricciones como presupuesto, plazos o dependencias heredadas
Por ejemplo, una plataforma de citas puede considerar críticos la creación de reservas, el procesamiento de pagos y las notificaciones a clientes. Una falla en un proceso interno de reportes puede ser inconveniente, mientras que una falla que genera citas duplicadas afecta directamente a los clientes.
Este contexto determina qué riesgos merecen atención primero.
Documenta la arquitectura actual
Una evaluación necesita una visión precisa del estado actual. Los diagramas existentes pueden ayudar, pero deben validarse contra la infraestructura desplegada, la configuración y el comportamiento real de la aplicación.
El inventario de arquitectura debe cubrir:
- Cuentas, regiones y entornos de AWS
- Redes y puntos de entrada externos
- Servicios de cómputo como Lambda, ECS o EC2
- Bases de datos, colas, buses de eventos y almacenamiento
- Rutas de identidad y acceso
- Pipelines de despliegue e infrastructure as code
- Mecanismos de monitoreo, logging, backup y recuperación
- Sistemas externos e intercambios de datos
Infrastructure as code, o IaC, significa definir recursos cloud mediante archivos versionados usando herramientas como AWS CloudFormation, AWS CDK o Terraform. Cuando existe IaC, aporta evidencia valiosa, pero puede no reflejar cambios manuales realizados directamente en AWS.
El objetivo no es producir un diagrama decorativo. El objetivo es hacer comprensibles los límites de servicio, las dependencias, los límites de confianza y los flujos de datos críticos.
Revisa los principales dominios de riesgo
Una evaluación práctica debe evaluar varios dominios conectados entre sí.
Seguridad
Revisa autenticación, autorización, cifrado, secretos, exposición pública, logging de auditoría y políticas de IAM.
IAM, o Identity and Access Management, controla qué usuarios y servicios pueden realizar acciones en AWS. Busca permisos amplios, credenciales compartidas, roles sin usar, autenticación multifactor faltante, y cargas de trabajo que pueden acceder a más recursos de los necesarios.
La evaluación también debe rastrear los datos sensibles desde el punto de entrada hasta el almacenamiento, en lugar de revisar servicios individuales de forma aislada.
Confiabilidad y recuperación
Identifica puntos únicos de falla, comportamiento de reintentos, configuración de timeouts, cobertura de backups y procedimientos de recuperación.
Confirma si los objetivos de recuperación están definidos. El Recovery Time Objective describe qué tan rápido debe restaurarse un sistema. El Recovery Point Objective describe cuánta pérdida de datos es aceptable.
Un backup no es evidencia suficiente de capacidad de recuperación. El equipo debería saber si la restauración se ha probado y quién es responsable de ejecutarla.
Rendimiento y escalabilidad
Revisa límites de servicio, concurrencia, patrones de acceso a bases de datos, caché, procesamiento asíncrono y cambios de tráfico esperados.
El objetivo no es maximizar la escala teórica. Es determinar si la arquitectura puede manejar la demanda realista sin latencia inestable, throttling o complejidad innecesaria.
Operaciones y entrega
Evalúa la seguridad de los despliegues, las opciones de rollback, la consistencia entre entornos, el monitoreo, la calidad de las alertas, la respuesta a incidentes y la propiedad operativa.
Preguntas útiles incluyen:
- ¿Puede el equipo identificar la causa de una solicitud fallida?
- ¿Se puede revertir un despliegue de forma segura?
- ¿Las alertas están vinculadas al impacto en el cliente?
- ¿Está documentado el conocimiento operativo crítico?
- ¿Puede otro ingeniero operar el sistema durante una ausencia?
Costos
Las revisiones de costos deben conectar el gasto con la arquitectura y el uso real.
Busca recursos inactivos, bases de datos sobredimensionadas, transferencia de datos excesiva, logging ineficiente, niveles de almacenamiento inadecuados y servicios cuyo modelo de precios no se ajusta a la carga de trabajo.
El diseño más barato no es automáticamente el mejor diseño. Reducir redundancia, observabilidad o retención de backups puede bajar la factura de AWS mientras aumenta el riesgo operativo.
Usa un flujo de trabajo basado en evidencia
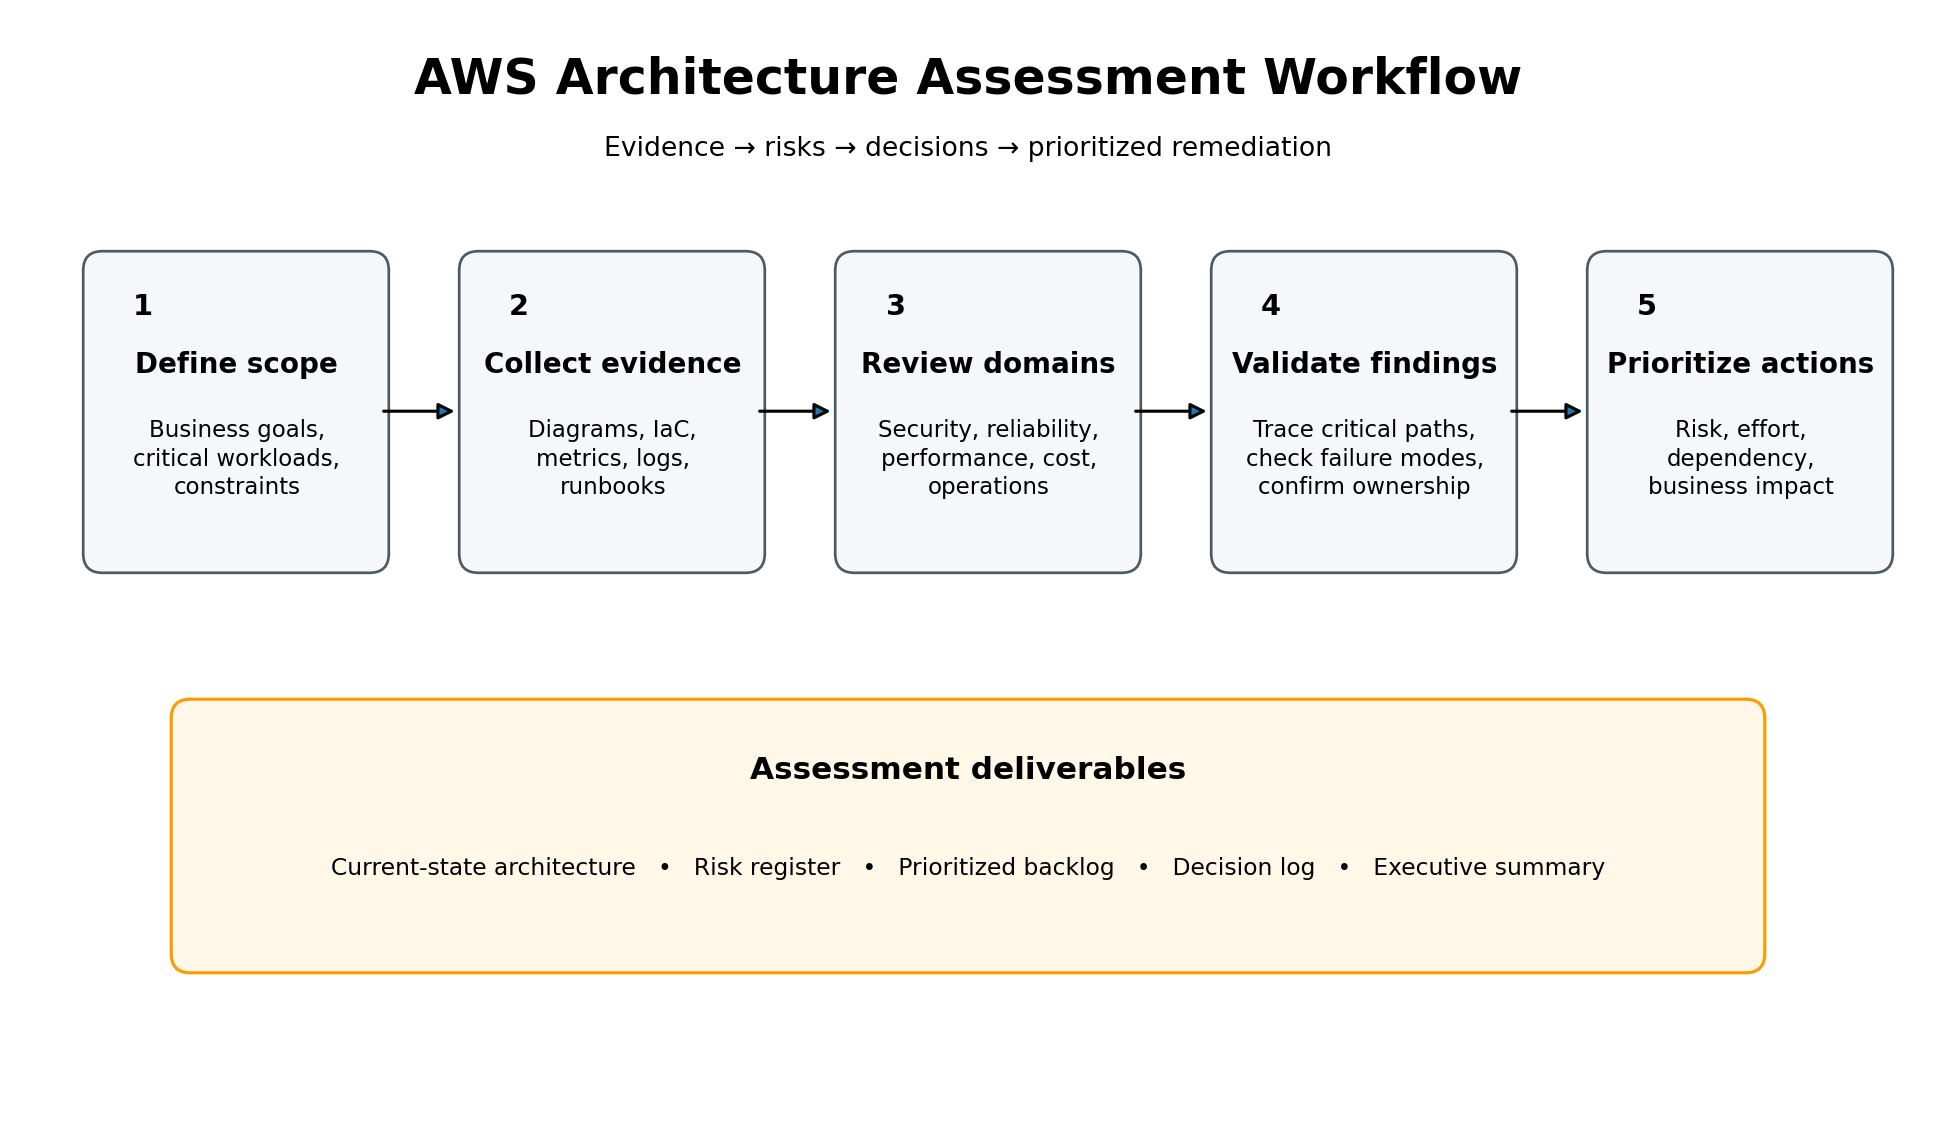
Una evaluación repetible puede seguir cinco pasos:
- Definir el alcance. Identificar cargas de trabajo críticas, expectativas de negocio y restricciones.
- Recolectar evidencia. Revisar diagramas, repositorios, IaC, configuración de AWS, logs, métricas, registros de incidentes y runbooks.
- Trazar rutas críticas. Seguir solicitudes importantes a través de APIs, servicios, bases de datos, colas y proveedores externos.
- Registrar y validar riesgos. Confirmar cada hallazgo con evidencia y discutir supuestos en disputa con el equipo responsable.
- Priorizar la remediación. Clasificar acciones por impacto, probabilidad, esfuerzo, dependencias y urgencia.
Los entregables finales normalmente deben incluir una arquitectura del estado actual, un registro de riesgos, un backlog de remediación priorizado, un resumen ejecutivo y las decisiones de arquitectura relevantes.
Ejemplo: procesamiento de pedidos serverless
Considera una API de pedidos que usa Amazon API Gateway, Lambda, DynamoDB, EventBridge y un proveedor de pagos externo.
La evaluación encuentra que Lambda escribe el pedido antes de llamar al proveedor de pagos. Si la solicitud de pago excede el tiempo de espera, el cliente reintenta y crea un segundo pedido porque no se utiliza una clave de idempotencia.
El problema no es simplemente “agregar reintentos”. Los reintentos sin control pueden agravar la duplicación.
Una recomendación práctica introduciría una clave de idempotencia, almacenaría explícitamente el estado del pago, y movería el procesamiento de pagos detrás de una cola duradera o un flujo de eventos. El backlog también debería incluir alarmas de pagos duplicados, procedimientos de conciliación y pruebas para escenarios de timeout.
Este hallazgo conecta un detalle de implementación con un riesgo de negocio concreto: pedidos duplicados y disputas de pago.
Compensaciones y errores comunes
Un error común es tratar las preguntas de AWS Well-Architected como la evaluación completa. El framework es útil, pero un cuestionario no puede reemplazar el rastreo del comportamiento de la aplicación, la revisión de código y la validación de los procedimientos operativos.
Otro error es producir una larga lista de hallazgos sin priorización. Veinte mejoras menores de configuración pueden distraer de un proceso de recuperación sin probar o un almacén de datos expuesto públicamente.
Las evaluaciones también tienen límites. Una revisión breve puede identificar riesgos visibles, pero puede no demostrar la corrección de la aplicación, el cumplimiento de seguridad o la preparación ante desastres. Esas conclusiones pueden requerir pruebas de penetración, pruebas de carga, ejercicios de restauración o un análisis de código más profundo.
Conclusión
Una evaluación de arquitectura AWS debe explicar el sistema actual, mostrar dónde existen riesgos materiales, y convertir esos riesgos en un backlog accionable. Las evaluaciones más sólidas combinan configuración cloud, comportamiento de la aplicación, evidencia operativa y contexto de negocio.
Comienza seleccionando un flujo de trabajo crítico y trazándolo desde la solicitud externa hasta sus efectos finales en datos y operaciones. Ese ejercicio suele revelar más que empezar con una lista de verificación genérica de servicios.