
Por qué el escalado de Lambda puede sobrecargar tu base de datos
AWS Lambda elimina gran parte del trabajo que implica escalar el cómputo de una aplicación, pero tu base de datos no gana automáticamente esa misma elasticidad. Un aumento repentino en la concurrencia de Lambda puede crear suficientes conexiones y consultas paralelas como para convertir un escalado de cómputo exitoso en una saturación de la base de datos.
La pregunta de diseño importante no es simplemente “¿Hasta dónde puede escalar Lambda?”. Es “¿Cuánto trabajo concurrente puede absorber la base de datos de forma segura?”
Lambda y las bases de datos relacionales escalan de forma distinta
La concurrencia de Lambda es el número de invocaciones de función ejecutándose al mismo tiempo. A medida que aumenta el tráfico, Lambda puede crear entornos de ejecución adicionales para procesar solicitudes en paralelo. AWS recomienda explícitamente entender las restricciones de throughput de los sistemas downstream, porque esas dependencias pueden no escalar al mismo ritmo que Lambda.
Una base de datos relacional como Amazon RDS o Aurora tiene restricciones distintas:
- CPU y memoria disponibles;
- capacidad máxima y práctica de conexiones;
- tiempo de ejecución de consultas;
- bloqueos y contención de transacciones;
- throughput de disco y de red.
Imagina una API donde cada invocación de Lambda abre una conexión a la base de datos.
Cliente
  |
API Gateway
  |
Lambda x 10
  |
Amazon RDS
Con tráfico bajo, esto puede funcionar perfectamente.
Ahora el tráfico aumenta:
Solicitudes de clientes
      |
  API Gateway
      |
Lambda Lambda Lambda Lambda Lambda ...
   \     |      |      |      /
        Base de datos
El escalado de cómputo funciona exactamente como se pretendía, pero la base de datos recibe de pronto mucho más trabajo en paralelo.
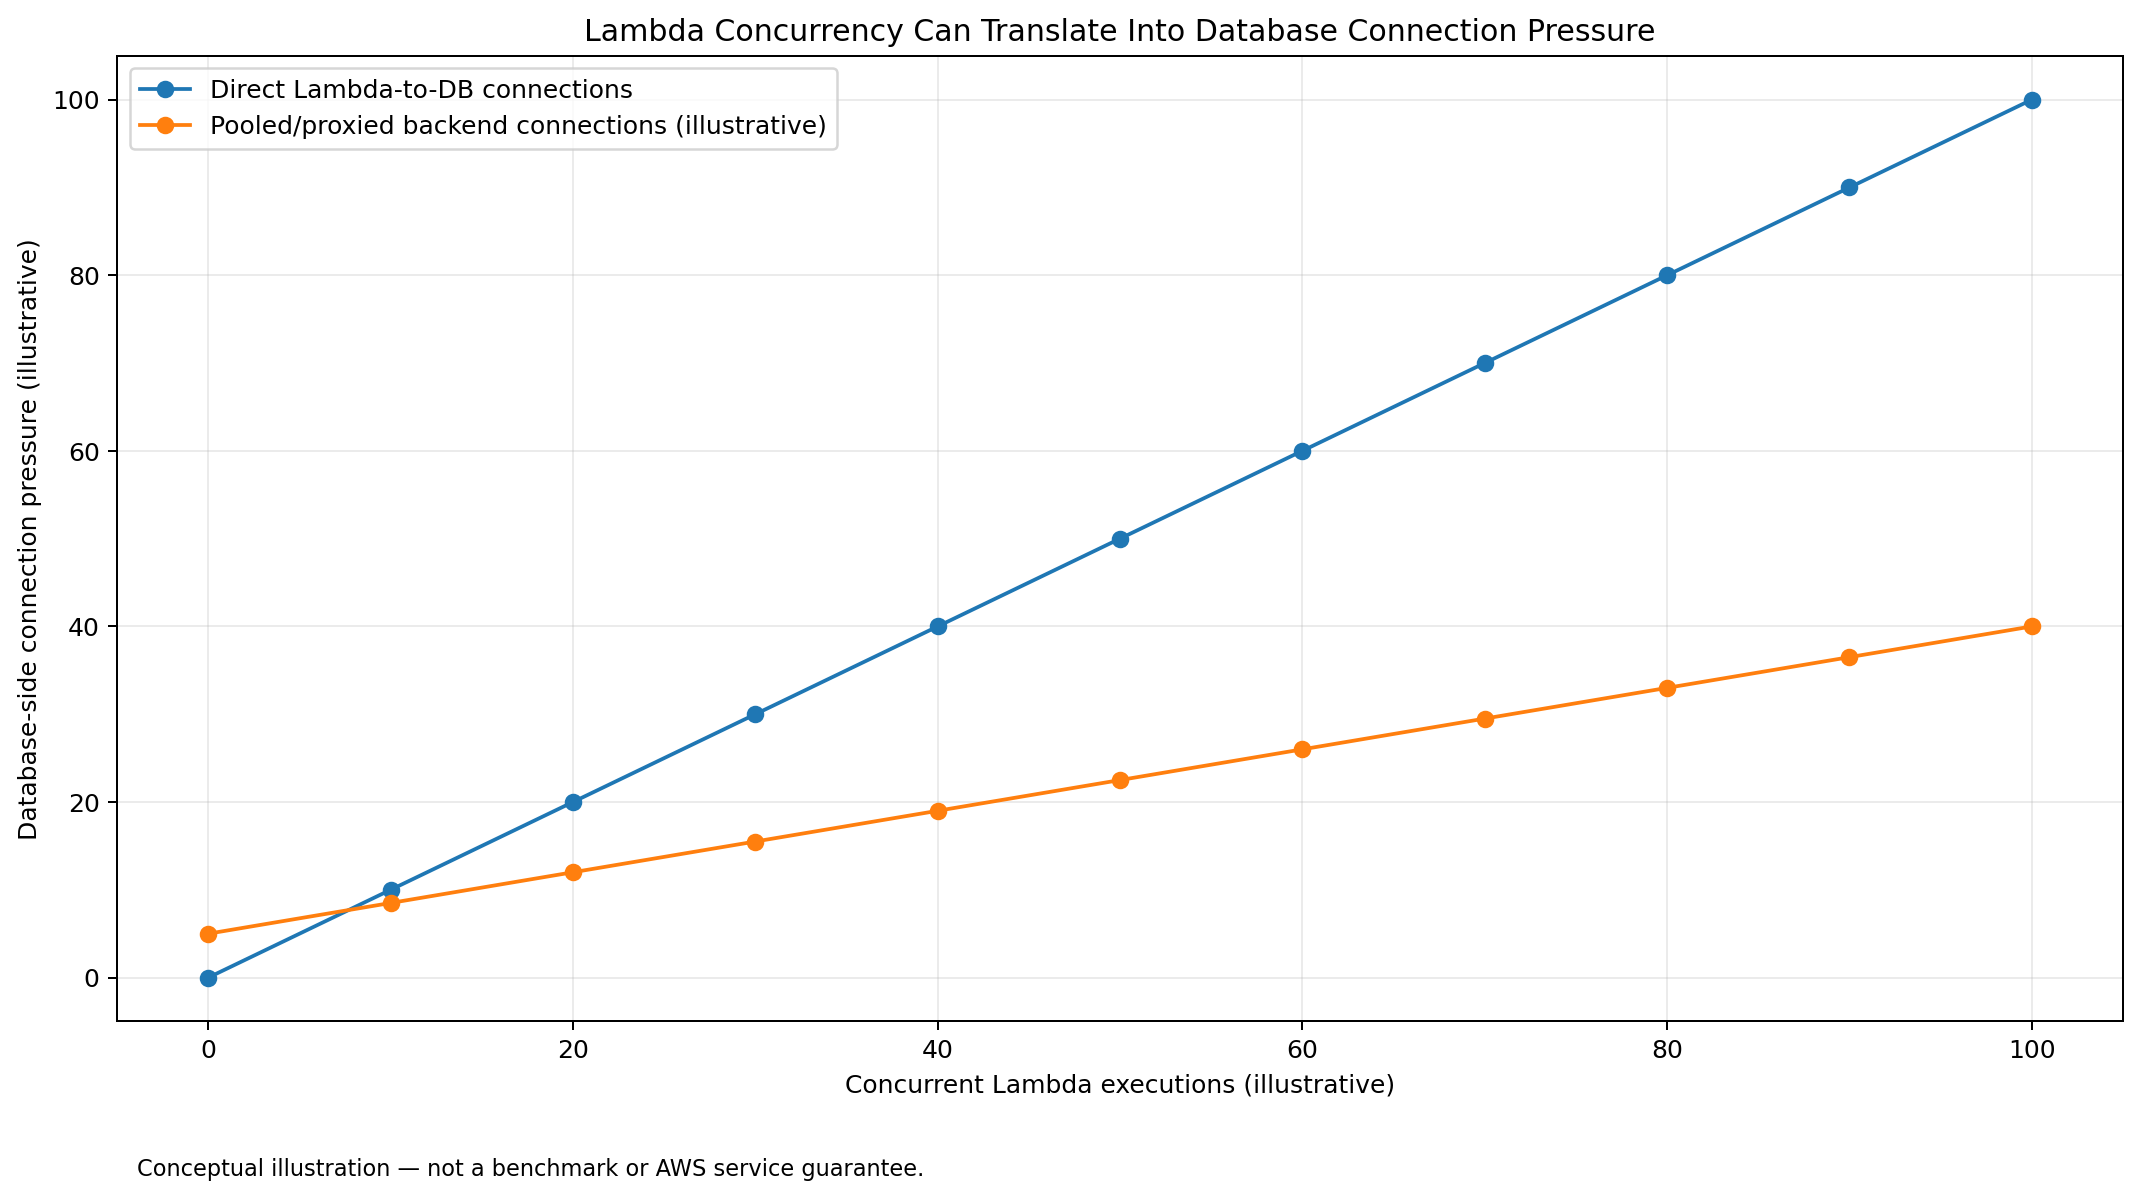
Diseña en función de la capacidad downstream
La solución no es impedir que Lambda escale. Es hacer que el escalado respete el margen de capacidad del sistema.
1. Determina el nivel de concurrencia seguro para la base de datos
Empieza por la base de datos, no por la cuota de Lambda.
Mide cuántas operaciones de aplicación concurrentes puede sostener la base de datos manteniendo niveles aceptables de:
- latencia de consultas;
- utilización de CPU;
- conexiones;
- desempeño de transacciones;
- tasas de error.
No confundas el número máximo de conexiones configurado en la base de datos con un objetivo de concurrencia seguro para la aplicación. Una base de datos que opera cerca de su límite absoluto de conexiones tiene poco margen para administración, migraciones, monitoreo u otras cargas de trabajo.
2. Reutiliza y agrupa conexiones (pooling)
Abrir una nueva conexión a la base de datos por cada solicitud genera trabajo adicional y desgaste de conexiones.
Para cargas de trabajo de Lambda que usan RDS, AWS recomienda Amazon RDS Proxy en escenarios de producción donde las funciones crean con frecuencia conexiones de corta duración. RDS Proxy mantiene un pool de conexiones compartido y puede multiplexar las conexiones de la aplicación hacia un número menor de conexiones a la base de datos.
La arquitectura se convierte en:
API Gateway
     |
   Lambda
     |
 RDS Proxy
     |
 Aurora / RDS
RDS Proxy ayuda a gestionar las conexiones, pero no vuelve económicas las consultas costosas ni elimina los límites de capacidad de la base de datos.
3. Pon un techo a la concurrencia cuando sea necesario
La concurrencia reservada puede establecer un límite superior a las ejecuciones simultáneas de una función Lambda. AWS identifica específicamente la protección de recursos downstream, como las conexiones a la base de datos, como un caso de uso de este control.
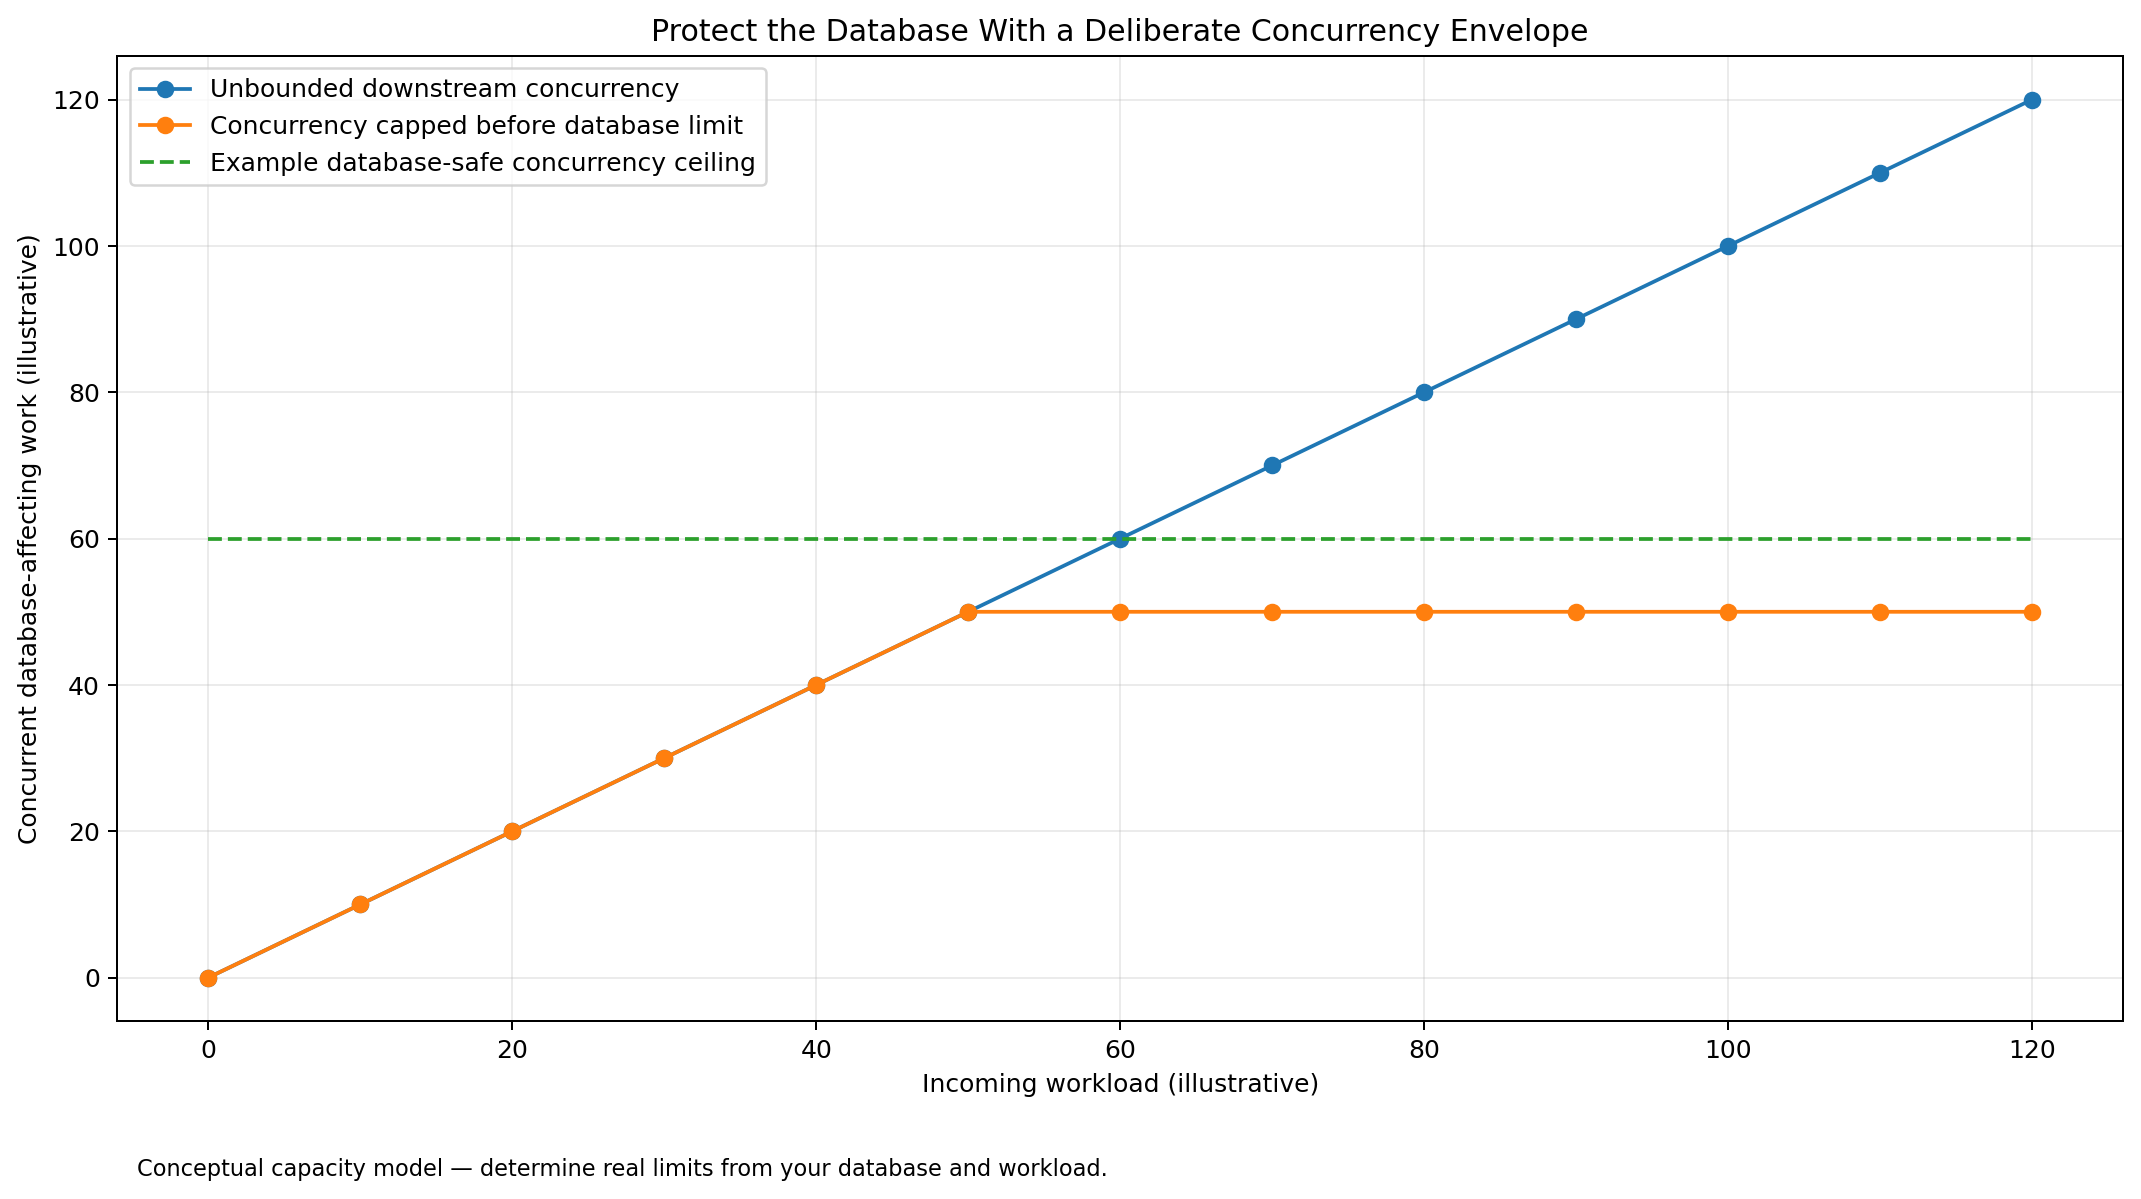
Por ejemplo, si las pruebas muestran que una carga de trabajo determinada nunca debería realizar más de 80 operaciones concurrentes sobre la base de datos, permitir que la función correspondiente se expanda indefinidamente probablemente sea un diseño incorrecto.
El trade-off es deliberado: las solicitudes excedentes pueden esperar o ser limitadas (throttled) en lugar de sobrecargar la base de datos.
Eso suele ser preferible a convertir un pico de tráfico temporal en una interrupción de toda la base de datos.
4. Introduce una cola cuando el trabajo no necesita una respuesta inmediata
Para cargas de trabajo asíncronas, SQS puede proporcionar contrapresión (backpressure):
Productor
   |
  SQS
   |
Workers Lambda
   |
RDS Proxy
   |
Base de datos
En lugar de permitir que el tráfico entrante dicte directamente la concurrencia de la base de datos, los mensajes se acumulan en la cola y los consumidores los procesan a un ritmo controlado.
Este patrón es especialmente útil para importaciones, notificaciones, procesamiento de documentos, trabajos de agregación y otras operaciones que no requieren una respuesta HTTP inmediata.
Ejemplo: importación de citas
Considera una aplicación SaaS que importa citas desde un sistema externo.
Normalmente procesa unos pocos registros por segundo. Un cliente sube un archivo con 20,000 citas, y la implementación invoca funciones de procesamiento de forma agresiva y en paralelo.
Cada invocación:
- busca al cliente;
- verifica si hay citas duplicadas;
- inserta la cita;
- actualiza datos relacionados.
Lambda puede aumentar la concurrencia rápidamente. La base de datos Aurora ahora recibe cientos de transacciones simultáneas en lugar de su carga habitual.
El mejor diseño es:
Carga
  |
SQS
  |
Lambda
(concurrencia máxima controlada)
  |
RDS Proxy
  |
Aurora
La importación puede tardar más, pero los usuarios interactivos siguen recibiendo un desempeño predecible de la base de datos.
Cuidado con la amplificación de reintentos
La saturación de la base de datos puede generar consultas lentas y fallos de conexión. Esos fallos pueden disparar reintentos desde clientes, SDKs, orígenes de eventos o código de aplicación.
Ahora una base de datos ya sobrecargada recibe solicitudes adicionales causadas por la propia sobrecarga.
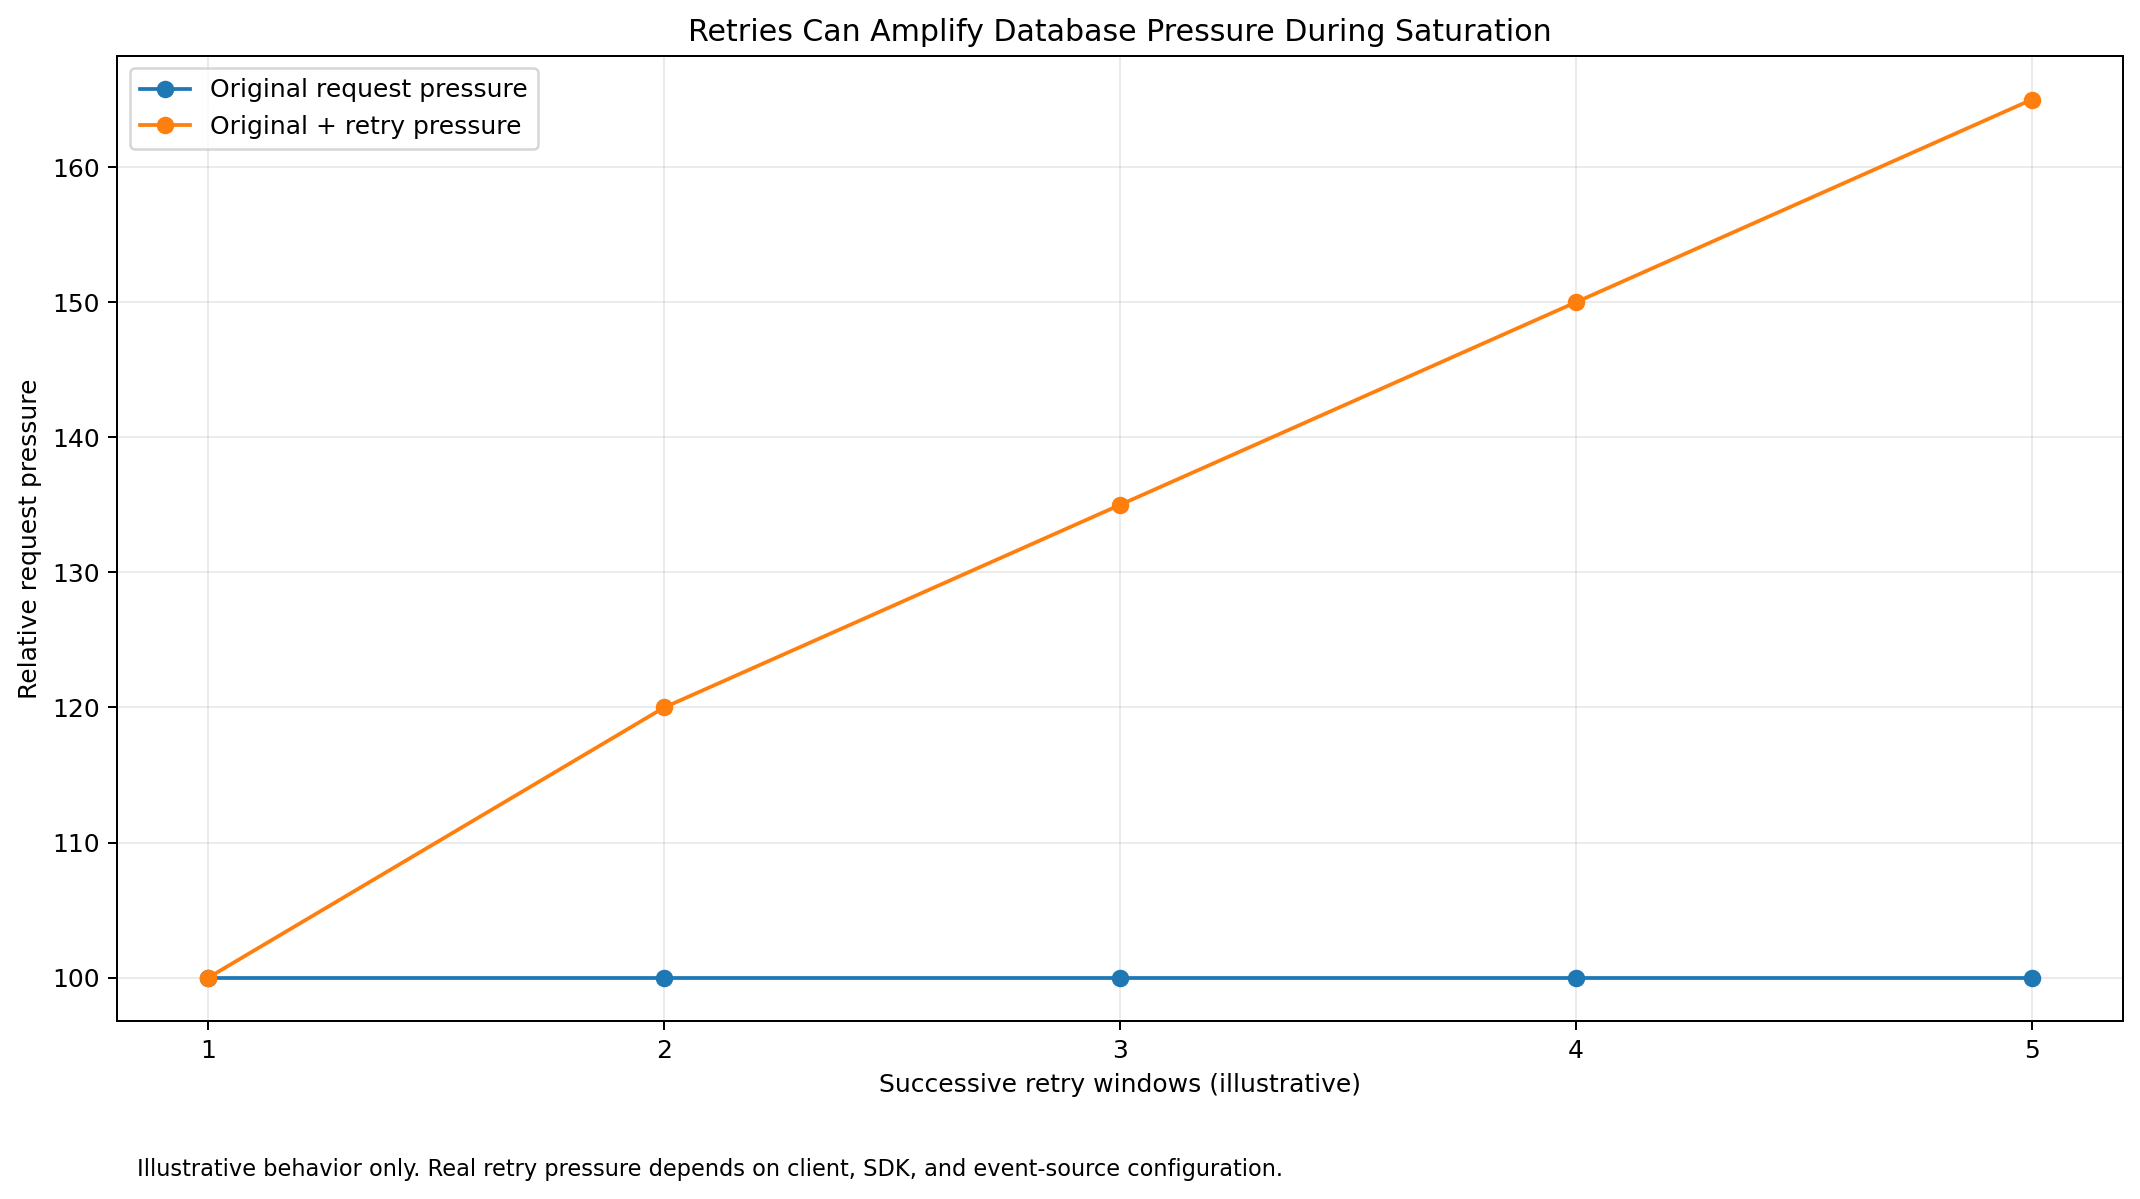
Por eso, los reintentos deben usar un número acotado de intentos, backoff exponencial y jitter cuando corresponda. Más importante aún, los reintentos no deben sustituir el control de la concurrencia.
Errores comunes
Un error común es asumir que “serverless” significa que todos los componentes escalan automáticamente. El cómputo serverless puede seguir dependiendo de recursos con capacidad fija o que cambian más lentamente.
Otro es agregar RDS Proxy y dar el problema por resuelto. El pooling de conexiones ayuda a gestionar las conexiones; no protege contra SQL ineficiente, bloqueos, transacciones excesivas o, simplemente, demasiado trabajo paralelo sobre la base de datos.
La concurrencia aprovisionada (provisioned concurrency) también se confunde a veces con un mecanismo de protección de la base de datos. Su propósito principal es mantener los entornos de ejecución de Lambda inicializados para reducir la latencia de arranque. La concurrencia reservada es el control relevante cuando necesitas un límite superior para la concurrencia de una función.
Conclusión
Una función Lambda escalable no crea automáticamente un sistema escalable. La arquitectura debe respetar la capacidad de su dependencia downstream más lenta.
Mide el rango de operación seguro de la base de datos, usa pooling de conexiones donde corresponda, limita la concurrencia cuando sea necesario e introduce colas cuando el trabajo pueda procesarse de forma asíncrona. Como siguiente paso práctico, compara la concurrencia máxima de cada función Lambda que interactúa con la base de datos frente a la capacidad de base de datos que tiene permitido consumir.