
Documentación de Arquitectura para Sistemas Serverless: Haz Visibles los Caminos de Ejecución
Los sistemas serverless eliminan gran parte de la gestión de infraestructura, pero no eliminan la complejidad arquitectónica. El comportamiento del negocio puede distribuirse entre funciones, buses de eventos, colas, bases de datos administradas, permisos, configuración de despliegue y políticas de reintento.
Una documentación útil debe ayudar a un ingeniero a responder rápidamente tres preguntas: qué sucede, dónde sucede y qué sucede cuando falla.
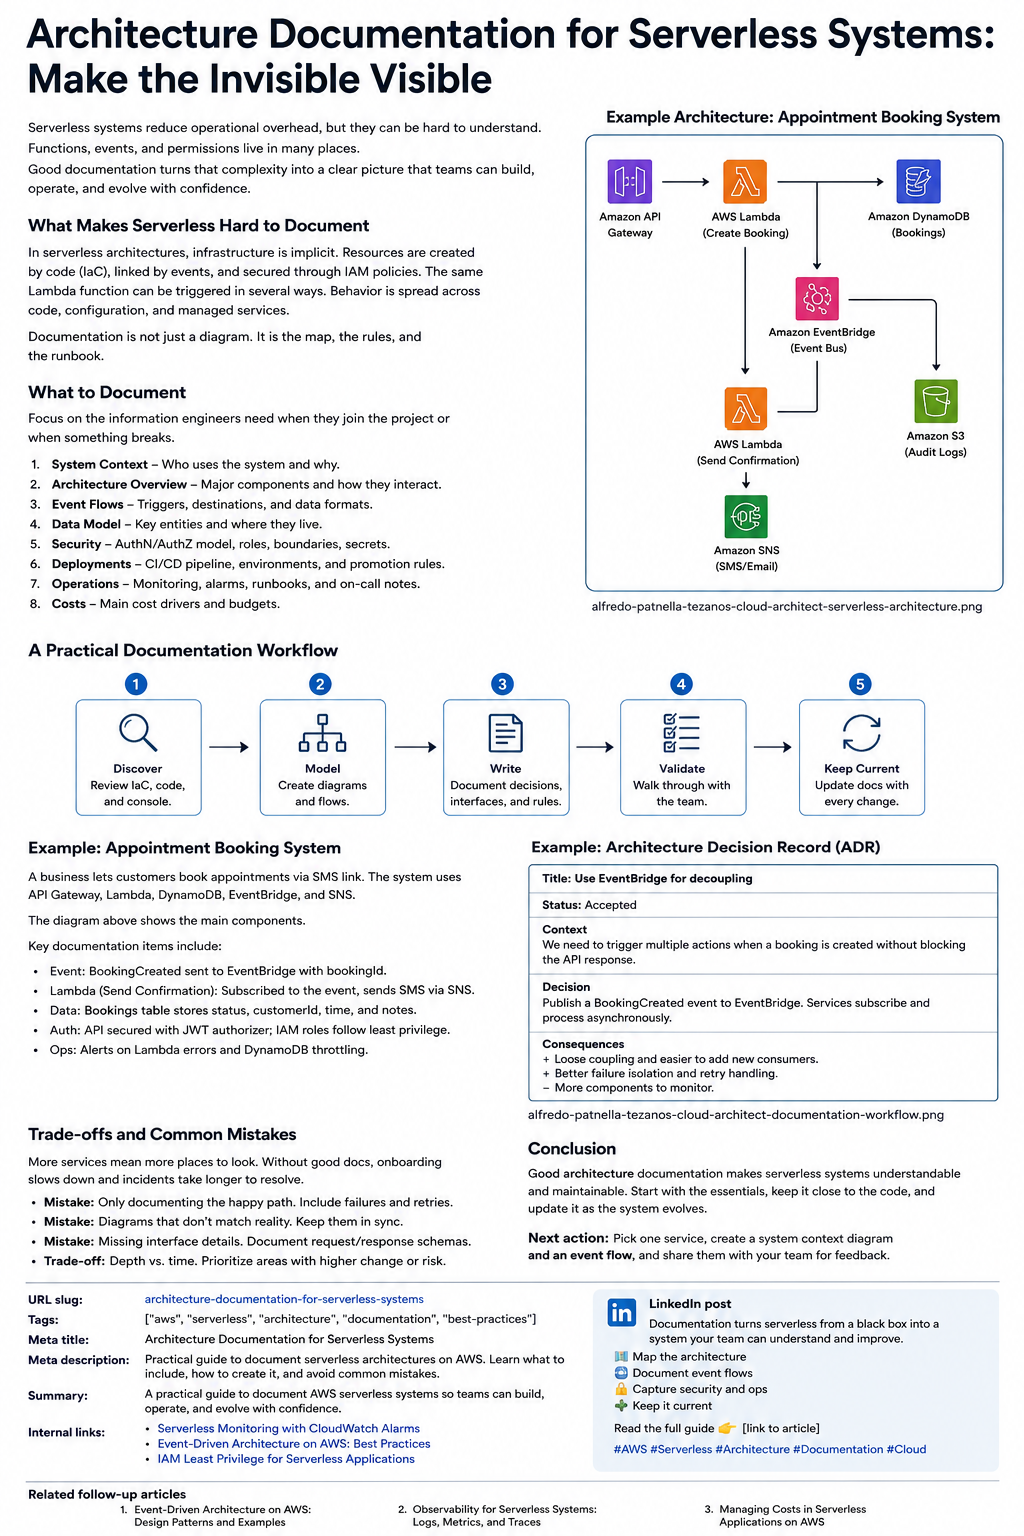
Qué debe explicar la documentación serverless
Una aplicación tradicional puede tener un pequeño número de servicios de larga duración con rutas de solicitud relativamente visibles. En un sistema serverless, una sola acción puede desencadenar varias operaciones asíncronas en componentes desplegados de forma independiente.
Por ejemplo, una solicitud a API Gateway puede invocar una función Lambda, escribir en DynamoDB, publicar un evento en EventBridge, activar otra función, enviar una notificación a través de SNS y colocar un evento fallido en una dead-letter queue.
Un inventario de servicios por sí solo no explica este comportamiento. La documentación debe capturar las relaciones entre servicios.
Como mínimo, documenta cuatro capas:
- Contexto del sistema: usuarios, sistemas externos, puntos de entrada y los límites de confianza principales.
- Arquitectura de componentes: funciones, APIs, bases de datos, colas, buses de eventos, almacenamiento e integraciones con terceros.
- Comportamiento en tiempo de ejecución: flujos de solicitudes, eventos, reintentos, rutas de falla y procesamiento asíncrono.
- Operaciones: despliegue, monitoreo, alarmas, procedimientos de recuperación, cuotas y responsabilidad.
Estas capas cumplen propósitos distintos. Un diagrama de contexto ayuda a un nuevo integrante del equipo a entender el sistema. Un documento de flujo de eventos ayuda a un desarrollador a modificarlo con seguridad. Un runbook ayuda al ingeniero de guardia a recuperarlo.
Un flujo de trabajo práctico de documentación
1. Reconstruye el sistema desplegado
Comienza con lo que realmente está desplegado, no con lo que dice un documento de diseño antiguo.
Revisa:
- Plantillas de infrastructure as code
- Configuración y triggers de Lambda
- Rutas de API Gateway
- Reglas de EventBridge
- Tópicos de SNS y colas de SQS
- Tablas e índices de DynamoDB
- Roles de IAM y políticas de recursos
- Alarmas y dashboards de CloudWatch
Infrastructure as code, o IaC, es código que define recursos cloud. AWS CDK, CloudFormation, Terraform y AWS SAM son ejemplos comunes.
El entorno desplegado sigue siendo la mejor referencia cuando el código y la documentación no coinciden.
2. Dibuja el contexto del sistema
Crea un diagrama pequeño que muestre:
- Usuarios principales
- Sistemas externos
- Puntos de entrada públicos y privados
- Límites de autenticación
- Datos que salen del sistema
No coloques cada función Lambda en este diagrama. Su propósito es dar orientación, no detalle de implementación.
3. Mapea las rutas de ejecución críticas
Selecciona los flujos de trabajo que más importan para el negocio o que generan mayor riesgo operativo.
Para cada flujo, documenta:
- Disparador (trigger)
- Componentes involucrados
- Datos escritos o publicados
- Pasos síncronos y asíncronos
- Comportamiento de reintentos
- Comportamiento de timeout
- Protección contra procesamiento duplicado
- Condición final de éxito
- Destino en caso de falla
La protección contra procesamiento duplicado se conoce comúnmente como idempotencia. Un handler idempotente puede procesar la misma solicitud o evento más de una vez sin producir un segundo resultado incorrecto.
4. Documenta contratos, no solo componentes
Los sistemas orientados a eventos dependen de contratos entre productores y consumidores.
Para un evento, registra:
eventName: BookingCreated
producer: CreateBookingFunction
destination: booking-events
requiredFields:
  - bookingId
  - customerId
  - tenantId
  - occurredAt
failureDestination: booking-events-dlq
El documento debe identificar la fuente de verdad del esquema completo. Evita mantener varias versiones copiadas manualmente del mismo contrato.
Para las APIs, documenta autenticación, forma de la solicitud, forma de la respuesta, códigos de error y responsabilidad.
5. Registra las decisiones importantes
Usa Architecture Decision Records (ADR) breves para decisiones que no sean evidentes a partir del código.
Un ADR útil contiene:
- Contexto
- Decisión
- Alternativas consideradas
- Consecuencias
- Estado
Por ejemplo, un ADR puede explicar por qué se eligió EventBridge en lugar de invocar directamente varias funciones Lambda. El valor importante no es la elección del servicio en sí, sino el razonamiento y las consecuencias aceptadas.
6. Agrega documentación operativa
Un diagrama no le indica a un ingeniero cómo responder ante un despliegue fallido o una cola que crece sin control.
Documenta:
- Dashboards relevantes de CloudWatch
- Umbrales de alarmas y responsabilidad
- Recuperación de la dead-letter queue
- Procedimientos de reprocesamiento (replay)
- Límites de concurrencia
- Cuotas de servicio
- Proceso de despliegue y rollback
- Diferencias específicas por entorno
- Reglas de retención y eliminación de datos
Mantén los runbooks lo suficientemente breves como para usarlos durante un incidente.
Ejemplo: flujo de reserva de citas
Considera una plataforma de citas serverless.
Un cliente envía una reserva a través de API Gateway. Una función Lambda valida la solicitud, almacena la cita en DynamoDB y publica un evento BookingCreated en EventBridge.
Una función de notificación consume el evento y envía una confirmación a través de SNS. Otro consumidor escribe un registro de auditoría en S3.
La documentación del flujo debe responder preguntas prácticas:
- ¿La reserva está completa después de la escritura en DynamoDB o después de la entrega de la notificación?
- ¿Qué sucede cuando EventBridge no puede invocar a un consumidor?
- ¿La función de notificación puede recibir el mismo evento dos veces?
- ¿Dónde puede un operador encontrar los eventos fallidos?
- ¿Qué equipo es responsable de reprocesarlos?
- ¿Una falla de notificación afecta la reserva confirmada?
Sin estas respuestas, un diagrama muestra conectividad, pero no comportamiento del sistema.
Compensaciones y errores comunes
Demasiado detalle se vuelve difícil de mantener
Un diagrama que contiene cada acción de IAM, variable de entorno y recurso generado quedará desactualizado rápidamente. Mantén los diagramas en el nivel necesario para la toma de decisiones y la resolución de problemas. Enlaza al código o a referencias generadas automáticamente para el detalle de bajo nivel.
El camino feliz no es suficiente
Los equipos suelen documentar la ejecución exitosa y omiten reintentos, throttling, fallas parciales y dead-letter queues. En los sistemas serverless, estas rutas son parte de la arquitectura, no detalles de implementación excepcionales.
Administrado no significa simple
AWS administra la infraestructura subyacente, pero la aplicación sigue siendo responsable de los permisos, los contratos de eventos, la concurrencia, los supuestos de orden y la recuperación ante fallas.
La documentación puede desalinearse de la realidad
Los documentos de arquitectura deben revisarse junto con cambios significativos de infraestructura o de flujo de trabajo. Trata la actualización de la documentación como parte del cambio, no como una tarea de limpieza separada.
Conclusión
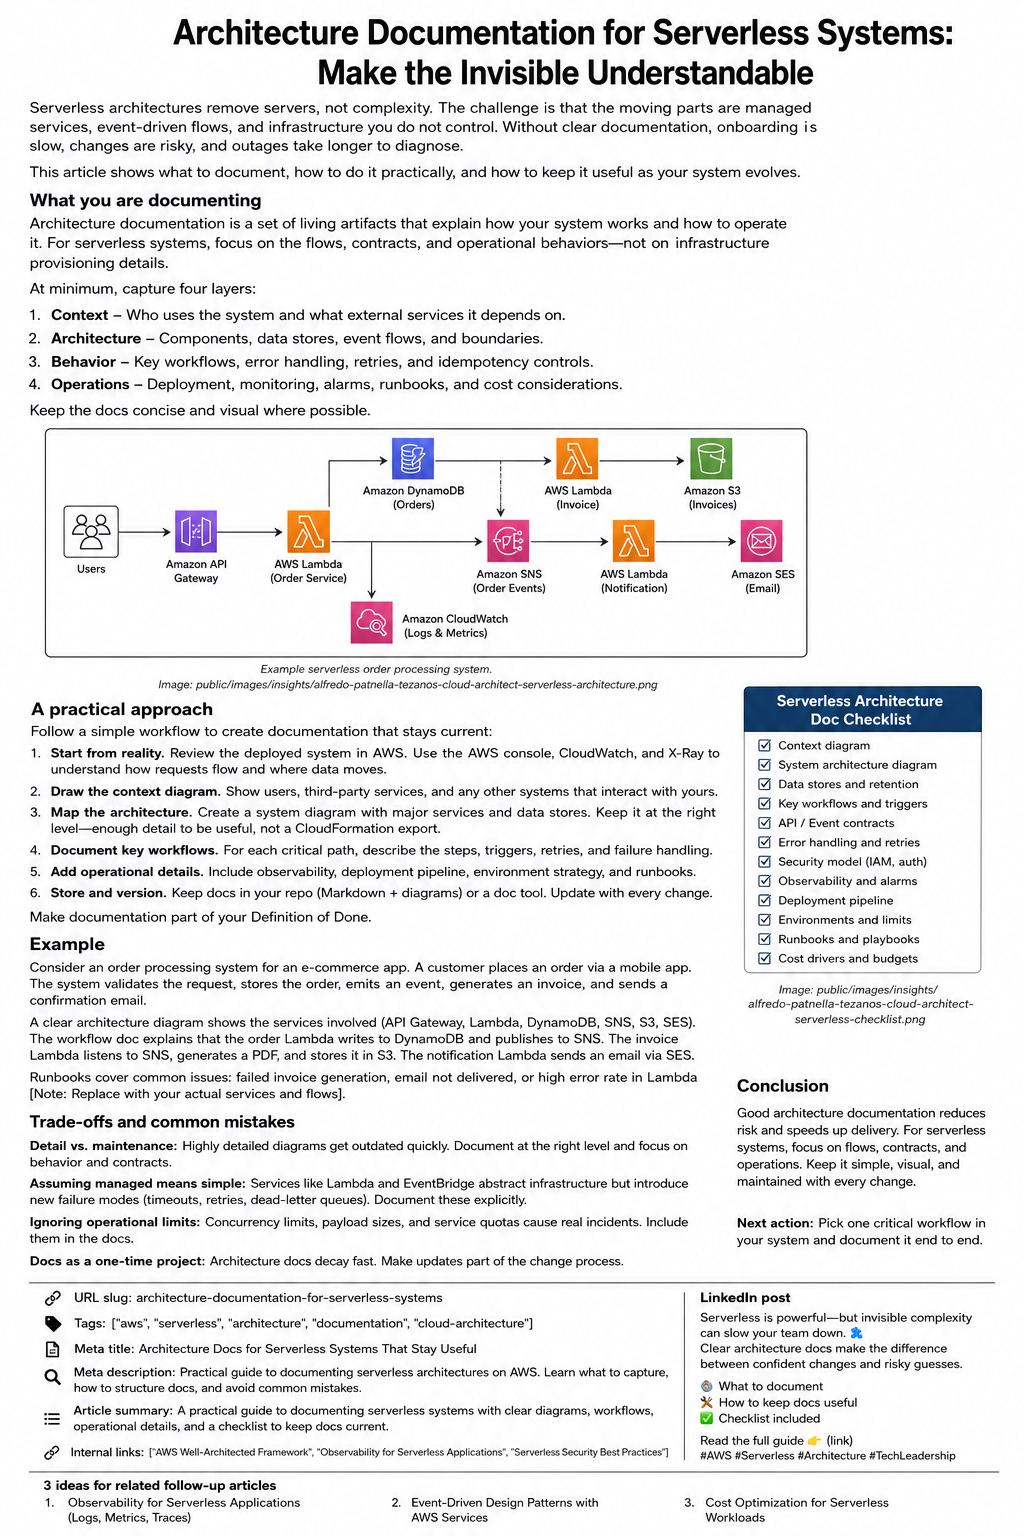
Una buena documentación serverless conecta los diagramas de arquitectura con los flujos de ejecución, los contratos, las decisiones y los procedimientos operativos. Debe ayudar a un ingeniero a entender un flujo crítico sin tener que reconstruir todo el sistema a partir de la configuración de AWS.
Comienza con una ruta crítica para el negocio. Documenta su disparador, sus servicios, el movimiento de datos, el comportamiento ante fallas y la recuperación operativa de principio a fin.