Riesgos Comunes de Arquitectura en AWS Fáciles de Pasar por Alto
La mayoría de los problemas de arquitectura en AWS no provienen de un diagrama obviamente malo. Surgen de servicios razonables conectados de formas que dejan una ruta de fallo, un desajuste de escalado, una exposición de seguridad o una brecha de recuperación.
La pregunta útil no es solo “¿funciona esta arquitectura?”, sino “¿qué pasa cuando una suposición deja de ser cierta?”
Mira las conexiones, no solo los servicios
Una función Lambda, una cola SQS, una base de datos RDS o un API Gateway pueden estar bien configurados de forma aislada mientras el sistema a su alrededor sigue siendo frágil.
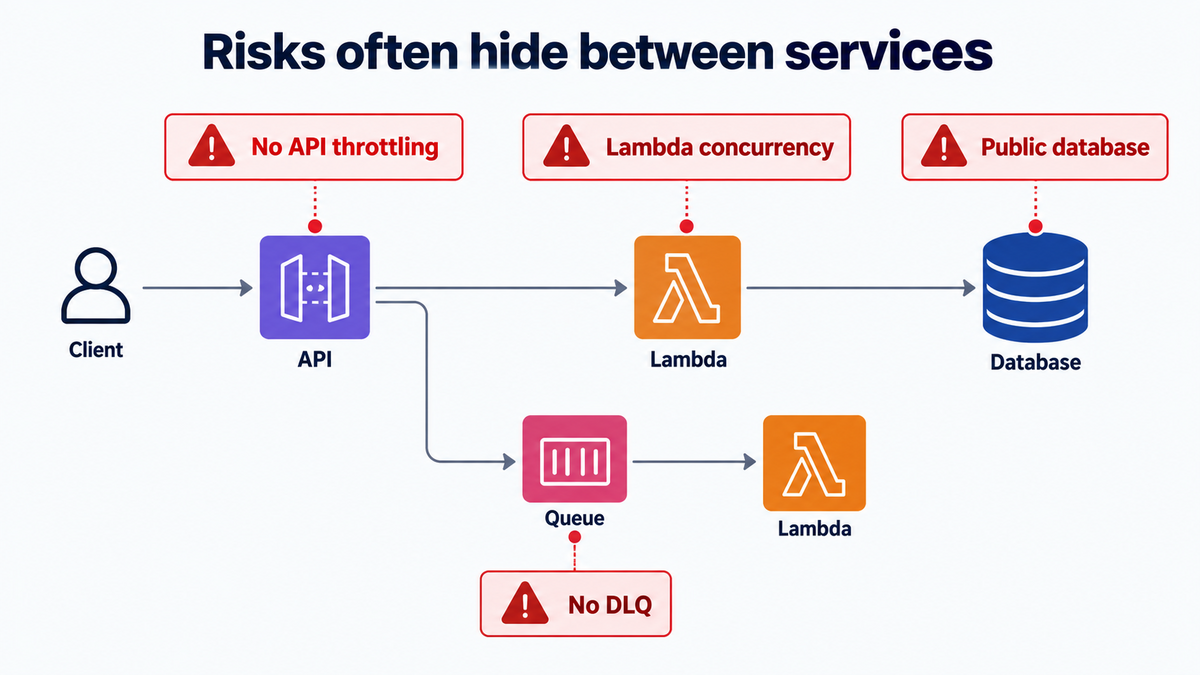
Por ejemplo, un flujo asíncrono con Lambda puede funcionar perfectamente con tráfico normal. Sin embargo, si los eventos fallidos no tienen a dónde ir, un problema transitorio en un servicio dependiente puede convertirse en trabajo perdido o en procesamiento repetido. De forma similar, Lambda puede escalar mucho más rápido de lo que una base de datos relacional puede aceptar nuevas conexiones.
Varios riesgos merecen una verificación explícita:
- Destinos de fallo ausentes. Las colas y las cargas de trabajo asíncronas necesitan una ruta de fallo deliberada. En SQS, eso normalmente significa una dead-letter queue (DLQ) y una política de redrive sensata.
- Desajustes de escalado. El cómputo serverless puede añadir concurrencia rápidamente mientras una base de datos, una API externa o un servicio legado tiene un límite seguro mucho más bajo.
- Suposiciones de recuperación débiles. “Los backups están habilitados” es distinto de saber que los datos pueden restaurarse dentro del objetivo de tiempo de recuperación (RTO) y del objetivo de punto de recuperación (RPO) requeridos.
- Acceso demasiado amplio. Permisos IAM con comodines, recursos públicos sin necesidad y reglas permisivas en security groups pueden sobrevivir porque la aplicación sigue funcionando.
- Secretos en la configuración. Las credenciales colocadas directamente en variables de entorno de Lambda o en la configuración de despliegue son más difíciles de rotar y más fáciles de exponer que los secretos gestionados mediante un servicio dedicado de secretos.
- Límites operativos ausentes. El throttling de APIs, los controles de concurrencia de Lambda, los visibility timeouts de las colas, los límites de conexiones de la base de datos y las cuotas de servicio son decisiones de arquitectura, incluso cuando no aparecen en el diagrama.
- Trampas de costo silenciosas. Los NAT gateways, las direcciones Elastic IP sin uso, la retención excesiva de logs y los recursos sobredimensionados pueden ser técnicamente válidos y aun así ser malas decisiones de arquitectura.
Un flujo de revisión práctico
Revisar una cuenta de AWS servicio por servicio es útil, pero no es suficiente. También hay que revisar el comportamiento a lo largo de toda la carga de trabajo.
- Rastrea cada ruta de solicitud y de evento. Sigue las solicitudes síncronas, los mensajes asíncronos, los trabajos programados y los flujos de datos desde el punto de entrada hasta la dependencia final.
- Pregunta cómo falla cada paso. Identifica reintentos, timeouts, DLQs, requisitos de idempotencia, comportamiento de respaldo y dónde puede un operador ver el fallo.
- Compara los límites de escalado. Encuentra el componente que escala más rápido y luego verifica si cada dependencia posterior puede absorber esa carga.
- Revisa las fronteras de confianza. Verifica la exposición pública, los security groups, las políticas de recursos, los permisos IAM, el cifrado y dónde viven los secretos.
- Pon a prueba la historia de recuperación. Identifica la configuración de backups, la retención, los procedimientos de restauración, las suposiciones Multi-AZ o multirregión y el requisito real de RTO/RPO.
- Revisa el costo como parte de la arquitectura. Busca recursos cuyo costo continúa incluso cuando el tráfico de la aplicación es bajo, además de patrones en los que la escala multiplica el gasto de forma inesperada.

Ejemplo: una API sana con un riesgo oculto en la base de datos
Considera un endpoint de API Gateway que invoca una Lambda, y esa Lambda escribe en Aurora. El tráfico es moderado, los errores son bajos y el CPU de la base de datos se ve sano.
Entonces una campaña provoca un pico repentino de tráfico. Lambda aumenta su concurrencia y cada ejecución abre una conexión a la base de datos. La base de datos alcanza su límite de conexiones antes de que el CPU se convierta en el cuello de botella. La API empieza a fallar aunque todos los servicios se veían sanos durante la revisión anterior.
La solución de arquitectura no es simplemente “hacer Aurora más grande”. Según la carga de trabajo, los mejores controles podrían incluir concurrencia reservada en Lambda, RDS Proxy para el pooling de conexiones, backpressure a nivel de aplicación, throttling en la API o una cola asíncrona entre componentes. Cada opción cambia la latencia, el costo y el comportamiento ante fallos.
Compromisos y errores comunes
El error más común es tratar cada hallazgo como algo que debe eliminarse. La arquitectura consiste en compromisos controlados.
Un endpoint público no es automáticamente inseguro. Una carga de trabajo sin DLQ no está automáticamente rota. Un despliegue multirregión no es automáticamente mejor. La pregunta correcta es si la configuración se ajusta a los requisitos de seguridad, disponibilidad, recuperación, rendimiento y costo de la carga de trabajo.
Los controles también tienen costos. Añadir colas mejora el desacoplamiento, pero introduce consistencia eventual y más estado operativo. Un throttling agresivo protege las dependencias, pero puede rechazar tráfico legítimo. Una retención de backups más larga mejora las opciones de recuperación, pero aumenta el costo de almacenamiento.
Haz que la revisión de riesgos sea continua
Una revisión útil de AWS conecta la configuración con el comportamiento: qué puede fallar, qué puede escalar, qué está expuesto, qué se puede recuperar y qué puede volverse inesperadamente caro. Empieza con una carga de trabajo en producción, rastrea sus rutas de extremo a extremo y convierte las suposiciones que encuentres en verificaciones explícitas.
Si el problema más difícil es mantener esa vista actualizada, ArchNube.com está construido alrededor de eso. Archnube Assess se conecta a través de un rol IAM de solo lectura, estrecho y controlado por el cliente, descubre los recursos de AWS soportados y aplica un motor de reglas determinista para producir hallazgos explicables sobre arquitectura riesgosa, débil, ineficiente o cuestionable. No necesita acceso de escritura a tu cuenta de AWS; el siguiente paso útil es comparar sus hallazgos con las suposiciones documentadas en tu propia revisión de arquitectura.