Las Primeras 10 Cosas que Reviso en una Cuenta de AWS Existente
Hacerse cargo de una cuenta de AWS existente rara vez es un ejercicio de documentación. La pregunta útil es si el entorno que realmente tienes coincide con la arquitectura que el equipo cree tener.
Antes de proponer cambios, quiero un mapa rápido del acceso, la exposición, los modos de falla, la recuperación, la observabilidad y el costo. Estas diez verificaciones me dan esa línea base.
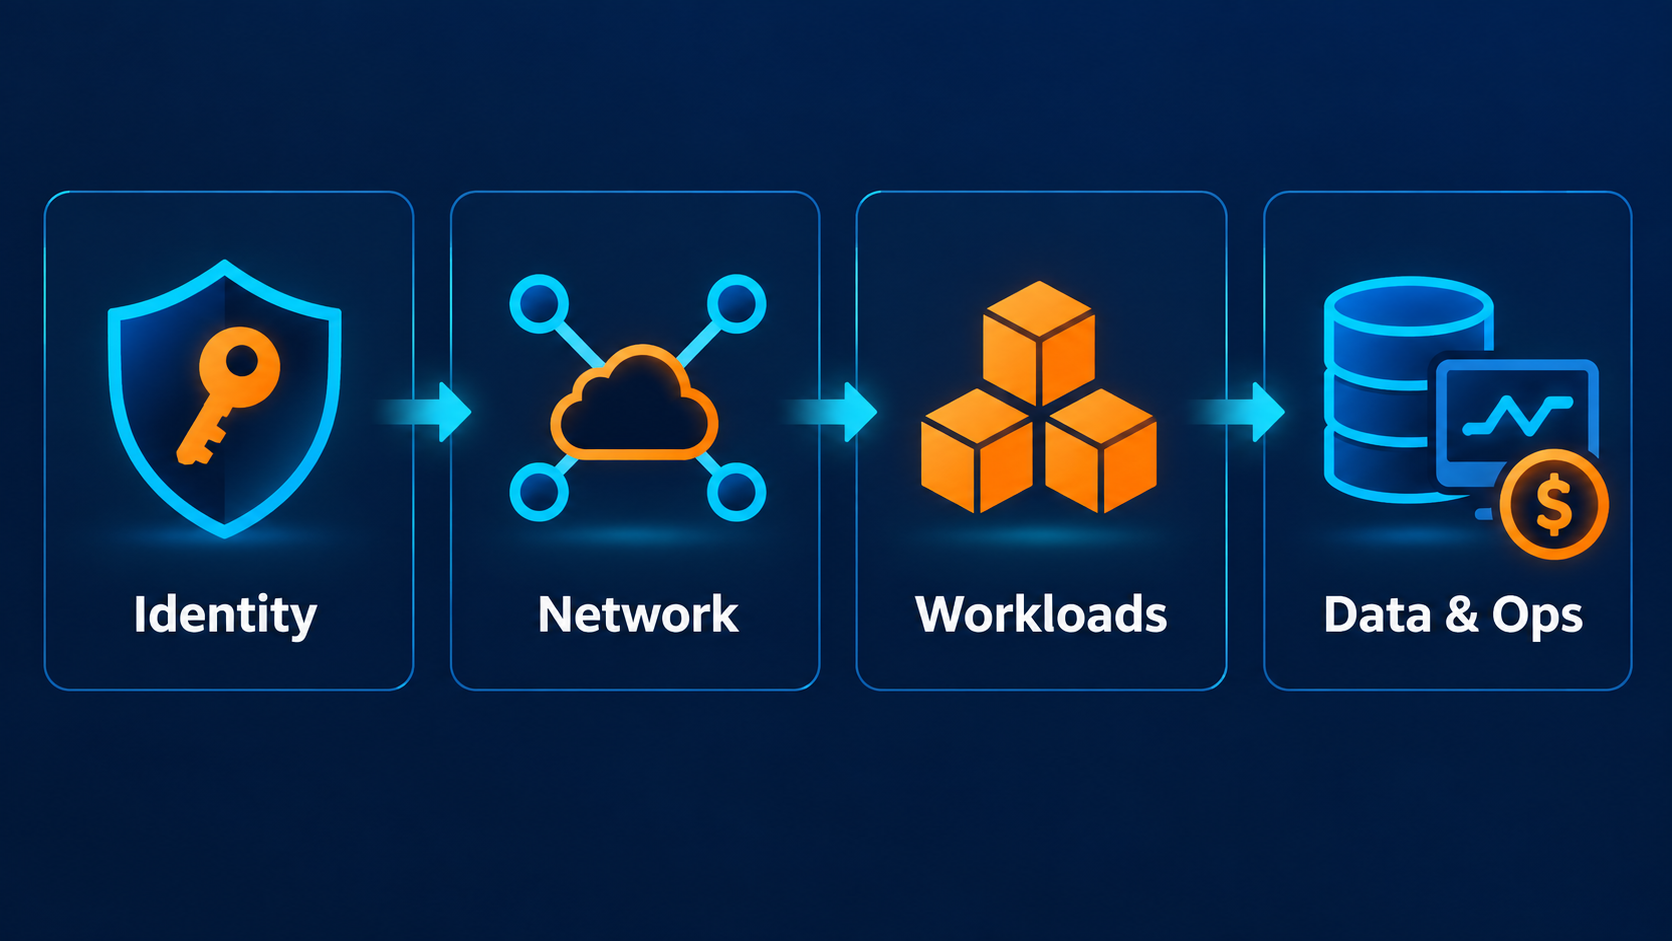
1. Identidad y acceso privilegiado
Empiezo con IAM. Busco cómo se autentican los humanos, dónde existen access keys de larga duración, qué roles tienen permisos amplios, y si las cargas de trabajo usan roles en lugar de credenciales embebidas.
El usuario root merece su propia verificación: cómo está protegido y si se usa para trabajo normal. También busco permisos con wildcards y políticas de confianza poco claras.
2. Estructura de cuenta y organización
A continuación, establezco el límite administrativo. ¿Es independiente o parte de AWS Organizations? ¿Qué cuentas separan producción, no producción, seguridad y servicios compartidos? ¿Qué Service Control Policies (SCP) aplican? Una configuración que parece local puede en realidad estar gobernada de forma centralizada.
3. Rastro de auditoría y visibilidad de configuración
Verifico si la actividad de la API y los cambios de configuración de recursos pueden reconstruirse. CloudTrail provee historial de actividad; AWS Config puede rastrear configuraciones y cambios de recursos soportados. También reviso a dónde van los logs, quién puede modificarlos y cuánto tiempo se retienen.
4. Límites de red
Mapeo VPCs, subredes, tablas de rutas, gateways, endpoints, security groups y network ACLs. Luego hago la pregunta más simple: ¿qué puede hablar con qué? Presto atención al ingress 0.0.0.0/0 en puertos sensibles y a bases de datos accesibles desde lugares que no necesitan acceso.
5. Puntos de entrada públicos
Listo todo lo que es intencionalmente accesible desde internet: distribuciones de CloudFront, load balancers, APIs de API Gateway, IPs públicas, y endpoints de almacenamiento o bases de datos públicos. El objetivo no es “cero recursos públicos”. Es una exposición deliberada y mínima, protegida en la capa correcta.
6. Cómputo y comportamiento en tiempo de ejecución
Inspecciono el cómputo realmente en uso. Reviso versiones de runtime, comportamiento de escalado, responsabilidad de parcheo, timeouts, controles de concurrencia y rutas de dependencias. Para Lambda, pregunto si un crecimiento rápido de concurrencia puede sobrecargar una base de datos downstream o una API de terceros.
7. Protección de datos y recuperación
Para los servicios con estado, reviso cifrado, backups, retención, versionado o point-in-time recovery donde sea relevante, y protección contra eliminación. No me detengo en “backups habilitados”. Pregunto qué debe restaurarse, hasta qué punto, en cuánto tiempo, y si la recuperación se ha ejercitado.
8. Rutas de falla asíncronas
Reviso los visibility timeouts de SQS, las dead-letter queues, las políticas de reintento, los destinos de Lambda, los targets de EventBridge y los supuestos de idempotencia.
Si un worker puede ejecutarse más tiempo que el visibility timeout de un mensaje de SQS, el mismo mensaje puede volverse visible de nuevo mientras el primer intento de procesamiento sigue en curso.
9. Observabilidad y señales operativas
Reviso las alarmas de CloudWatch, los dashboards, los grupos de logs, la retención y los errores a nivel de aplicación. ¿Puede el equipo responder: el servicio está saludable? Qué cambió? Dónde está fallando? Las alarmas deben representar condiciones sobre las que alguien puede actuar, no cada métrica que expone AWS.
10. Arquitectura de costos
Finalmente, veo a dónde va el dinero y si la arquitectura lo explica. Reviso los costos de los principales servicios, los recursos inactivos, el uso de NAT gateway, el almacenamiento o las IP sin asociar, la ingesta de logs, la transferencia de datos y la calidad del etiquetado. Un costo sorprendente puede revelar rutas de tráfico inesperadas o recursos olvidados.
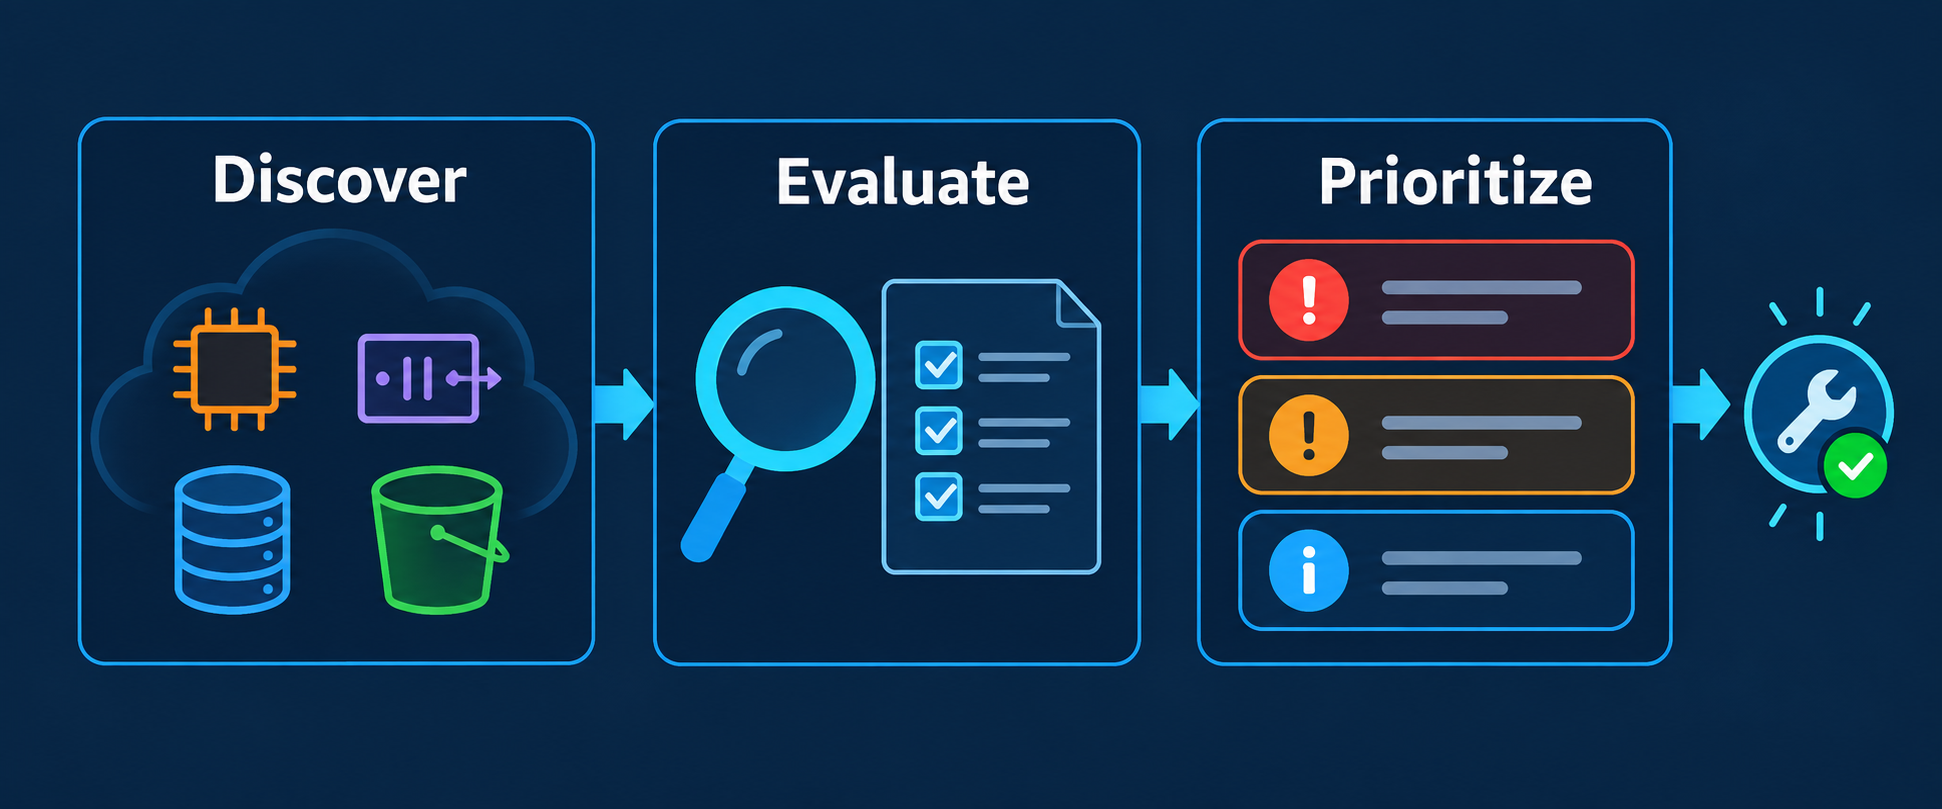
Una primera pasada realista
Imagina heredar una pequeña cuenta SaaS serverless. El diagrama dice API Gateway, Lambda, SQS y Aurora. La revisión muestra algo más útil: una Lambda puede escalar contra Aurora sin un límite de concurrencia, un visibility timeout de SQS es más corto que el peor caso de tiempo de procesamiento, un security group expone ampliamente un puerto de base de datos, y varios grupos de logs retienen datos indefinidamente.
Ninguno de esos hallazgos por sí solo describe toda la arquitectura. Juntos te dicen dónde investigar primero: exposición, comportamiento ante fallas, protección de la base de datos y costo operativo.
Compensaciones y errores comunes
El error más grande es convertir esto en un checklist de cumplimiento. Un security group amplio puede ser una exposición seria o una excepción temporal controlada; una dead-letter queue faltante puede ser un mal diseño o irrelevante para una ruta de invocación síncrona. El contexto cambia la severidad.
El segundo error es cambiar recursos mientras todavía los estás descubriendo. Empieza en modo solo lectura, registra evidencia, confirma la intención, y luego prioriza la remediación. Las reglas automatizadas pueden encontrar candidatos, pero aún necesitan contexto arquitectónico.
Construye la línea base antes de rediseñar
Una buena revisión de cuenta de AWS debería dejarte con tres cosas: un inventario confiable, una lista corta de riesgos explicables, y un conjunto priorizado de preguntas para el equipo. Eso es suficiente para pasar de “deberíamos mejorar esta cuenta” a decisiones arquitectónicas específicas.
Si producir esa línea base manualmente está tomando demasiado tiempo, ArchNube.com está construido para este problema. Archnube Assess se conecta a través de un rol IAM estrecho, de solo lectura y controlado por el cliente, descubre los recursos de AWS soportados y aplica reglas deterministas para producir hallazgos explicables, sin acceso de escritura ni juicio de IA de caja negra. Usa los hallazgos como punto de partida para la revisión arquitectónica, y luego aplica el contexto de negocio que solo tu equipo tiene.