¿Cómo Entiendes un Entorno de AWS que No Construiste?
Una cuenta de AWS desconocida rara vez se explica por sí sola. Los nombres de los recursos pueden ser inconsistentes, los diagramas pueden estar desactualizados, y una lista de servicios te dice muy poco sobre cómo funciona realmente el sistema.
El objetivo de una primera revisión de arquitectura no es rediseñarla. Es construir una imagen basada en evidencia de qué existe, cómo se mueven las solicitudes y los eventos, dónde están los límites de confianza, y qué preguntas necesitan respuesta.
No empieces por la lista de recursos
Un inventario es útil, pero la arquitectura se trata sobre todo de relaciones. Una función Lambda importa por lo que la invoca, a qué puede acceder, hacia dónde van las fallas, y qué datos modifica.
Así que empieza por los bordes y traza hacia adentro. Encuentra los puntos de entrada públicos: registros de Route 53, distribuciones de CloudFront, APIs de API Gateway, load balancers, u otros endpoints alcanzables externamente. Luego sigue las solicitudes hacia el cómputo y los almacenes de datos. Por separado, traza las rutas asíncronas a través de servicios como EventBridge, SNS, SQS y Lambda.
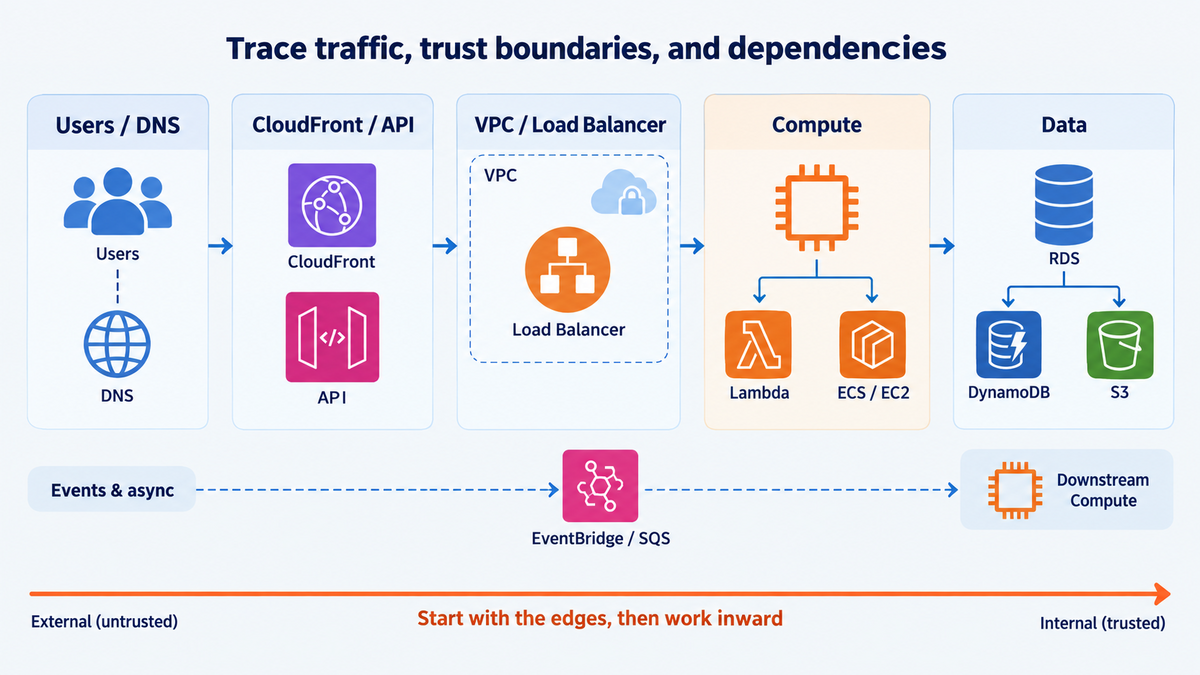
Esto te da un mapa del sistema funcional en lugar de un catálogo de servicios.
Usa cuatro pasadas antes de sacar conclusiones
Intentar entender todo de una vez crea ruido. Yo dividiría la revisión en cuatro pasadas.
-
Inventario — ¿Qué existe? Identifica cuentas, regiones, VPCs, puntos de entrada, cómputo, almacenes de datos, colas, buses de eventos, almacenamiento, roles de IAM, secretos y recursos de monitoreo. Los repositorios de infrastructure as code y las etiquetas pueden agregar contexto útil, pero verifícalos contra los recursos desplegados.
-
Relaciones — ¿Qué habla con qué? Traza solicitudes síncronas, fuentes de eventos, consumidores de colas, permisos de IAM, rutas de security groups, clientes de bases de datos, acceso a buckets y relaciones entre cuentas. Aquí es donde empieza a emerger una arquitectura.
-
Controles — ¿Cómo está protegido? Revisa la exposición pública, el alcance de IAM, el cifrado, el manejo de secretos, la configuración de backup y recuperación, los límites de red, y el manejo de fallas. Registra lo que puedes demostrar por separado de lo que todavía necesitas preguntar.
-
Operaciones — ¿Cómo se comporta? La configuración muestra la estructura prevista; las métricas y los logs muestran el comportamiento en tiempo de ejecución. Busca errores, throttling, profundidad de colas, latencia, presión sobre la base de datos, comportamiento de escalado, y alarmas relevantes para las rutas que identificaste.
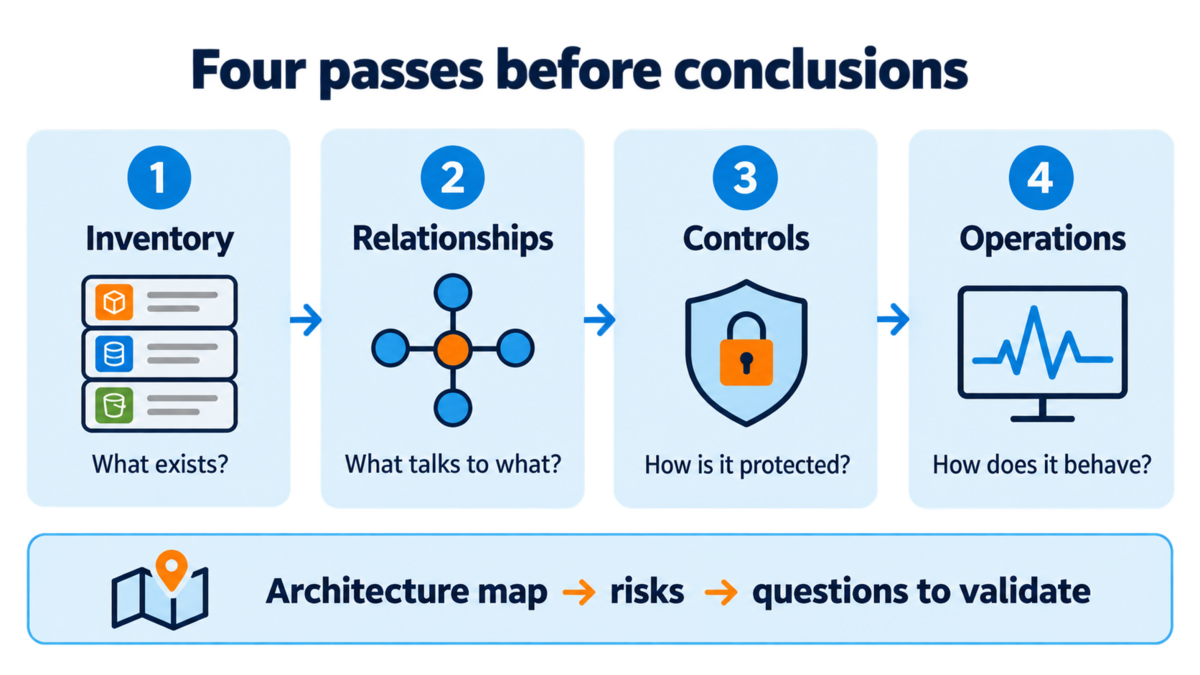
El resultado debería ser un mapa de arquitectura actual, riesgos priorizados, y preguntas que requieren contexto humano.
Ejemplo: la Lambda que parece incorrecta
Supongamos que encuentras una función Lambda dentro de una VPC que se conecta a un cluster de Aurora. Tiene un timeout de 15 minutos, ninguna dead-letter queue evidente, y acceso amplio a varios recursos.
Sería fácil etiquetar los tres como defectos. Eso sería prematuro.
Traza la función primero. Quizás API Gateway la invoca de forma síncrona, en cuyo caso una dead-letter queue en la función Lambda no es el mecanismo de falla relevante. El timeout largo puede ser innecesario, o puede soportar una ruta específica en segundo plano. Los permisos amplios pueden ser excesivos, pero necesitas identificar de qué APIs dependen realmente el código y el runtime antes de proponer una política más restringida.
Luego examina la evidencia operativa. ¿La función se acerca a su timeout? ¿Aurora muestra presión de conexiones cuando escala? ¿Las fallas son visibles para los operadores?
La distinción importante es observación versus conclusión. “El timeout está configurado en 900 segundos” es una observación. “Este timeout es inseguro” es una conclusión que necesita contexto.
Haz que los hallazgos sean explicables
Para cada problema, mantén la evidencia cerca del hallazgo. Un registro útil contiene el recurso afectado, la configuración observada, por qué importa, la severidad, y una dirección de remediación. Eso hace que la revisión sea depurable: otro ingeniero puede inspeccionar la misma evidencia y cuestionar la conclusión.
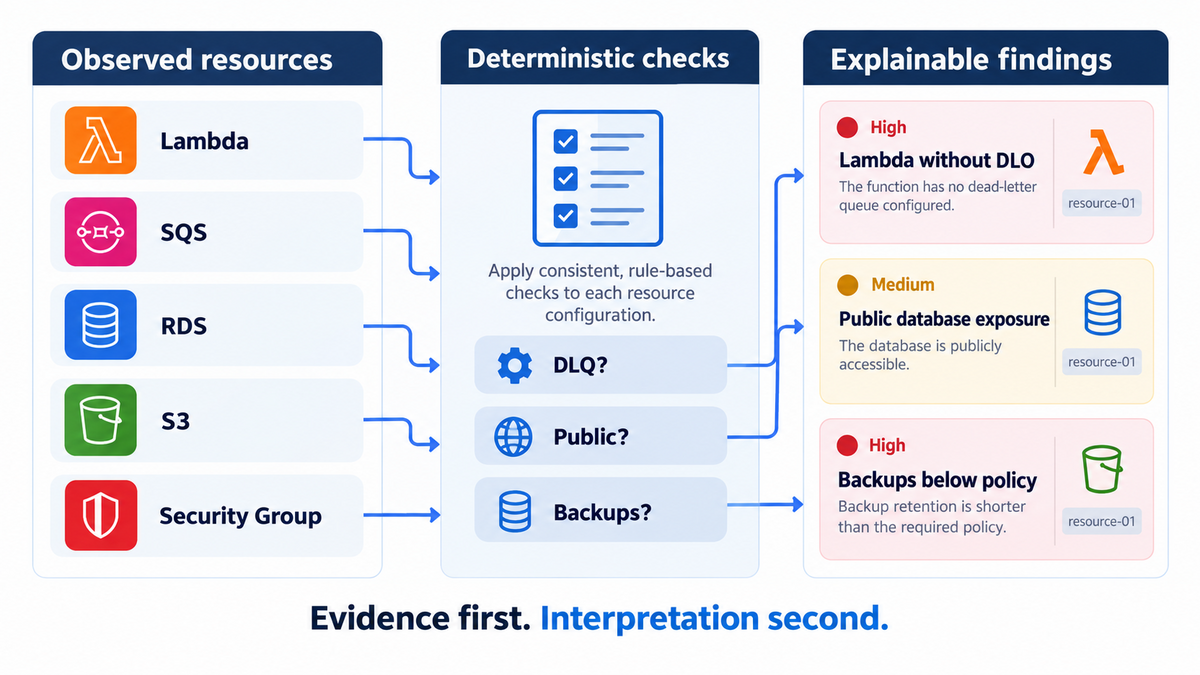
La automatización puede recolectar evidencia y las reglas deterministas pueden marcar condiciones conocidas, pero la intención de negocio a menudo vive fuera de AWS.
Errores comunes y compensaciones
El error más grande es cambiar recursos mientras todavía los estás descubriendo. Una cola, regla de seguridad o trabajo programado que se ve extraño puede soportar una dependencia que aún no has encontrado.
Otro error es tratar la configuración como prueba de uso. Un grafo de recursos puede mostrar que una Lambda puede alcanzar una base de datos; no prueba qué queries se ejecutan en producción ni si la ruta es crítica para el negocio. Los logs, las métricas, el código, las definiciones de infraestructura, y las conversaciones con el equipo llenan diferentes vacíos.
Finalmente, el descubrimiento de solo lectura reduce la necesidad de permisos de escritura, pero aún necesita un alcance deliberado. Muy poca visibilidad produce un modelo incompleto; una visibilidad innecesariamente amplia expone información que la evaluación no necesita. Define explícitamente los servicios soportados y los permisos de lectura requeridos.
Construye el mapa antes de proponer el destino
Al heredar un entorno de AWS, resiste el impulso de empezar por las mejores prácticas. Primero establece qué existe, traza las rutas importantes, valida los controles y el comportamiento en tiempo de ejecución, y separa los hechos de los supuestos. Entonces tus recomendaciones tendrán una razón arquitectónica detrás.
Si quieres automatizar parte de esa primera evaluación, ArchNube.com aborda exactamente este problema. Archnube Assess se conecta a través de un rol IAM de solo lectura, estrecho y controlado por el cliente, descubre los recursos de AWS que soporta, y aplica reglas deterministas para producir hallazgos explicables sobre riesgos, debilidades, ineficiencias y configuraciones cuestionables. No requiere acceso de escritura a la cuenta de AWS. El siguiente paso útil es el mismo en cualquier caso: establecer una línea base confiable antes de decidir qué cambiar.