Checklist de Revisión de Arquitectura AWS: Qué Examinar Antes de Producción
Una carga de trabajo puede desplegarse con éxito y aun así no estar lista para producción. Antes del lanzamiento, la pregunta útil no es simplemente “¿funciona?” sino “¿qué pasa cuando el tráfico crece, falla una dependencia, se filtran credenciales, o alguien necesita restaurar datos?”.
Una revisión de arquitectura debe hacer explícitos esos modos de falla mientras todavía hay tiempo para cambiar el diseño.
Revisa la carga de trabajo como un sistema
Evita revisar los servicios de AWS como cajas aisladas. Traza rutas reales a través de la arquitectura: una solicitud entrante, un trabajo asíncrono, una escritura en base de datos, un despliegue y una operación de recuperación. Una función Lambda segura puede seguir estando detrás de una API sin protección; una base de datos Multi-AZ hace poco por la disponibilidad si la aplicación corre en una sola instancia.
Para cada ruta importante, examina cinco áreas.
1. Seguridad y acceso
Comienza con la exposición y la identidad. ¿Qué recursos son alcanzables desde internet? ¿Las cargas de trabajo están en subredes públicas porque deben estarlo, o porque fue conveniente? Revisa los roles de IAM en busca de permisos amplios, reglas de security groups, cifrado, almacenamiento de secretos y autenticación en cada punto de entrada público.
El principio de mínimo privilegio significa otorgar solo las acciones y recursos que un principal realmente necesita. Presta especial atención a los permisos de IAM con wildcards y a las credenciales almacenadas en variables de entorno de Lambda, código fuente o configuración de despliegue.
2. Confiabilidad y comportamiento ante fallas
Pregunta qué sucede cuando cada dependencia deja de estar disponible. Busca componentes de una sola AZ, colas sin dead-letter queues (DLQ), límites de reintento faltantes y cadenas síncronas donde un servicio lento puede agotar la capacidad aguas arriba.
Para cargas de trabajo impulsadas por SQS, verifica que el visibility timeout se ajuste al tiempo real de procesamiento y que los consumidores sean idempotentes, es decir, seguros de ejecutar más de una vez para el mismo mensaje. Para las bases de datos, revisa los backups, el diseño de failover y los procedimientos reales de restauración, no solo si los backups están habilitados.
3. Límites de escalado y rendimiento
El autoescalado mueve los cuellos de botella; no los elimina. Una función Lambda puede escalar más rápido de lo que Aurora puede aceptar conexiones. Un Application Load Balancer puede distribuir el tráfico correctamente mientras una API downstream alcanza un límite de tasa.
Identifica cuotas, pools de conexiones, límites de concurrencia, timeouts, throttling, comportamiento de caché, profundidad de colas y capacidad de la base de datos. Define dónde ocurre la contrapresión (backpressure) cuando la demanda supera la capacidad.
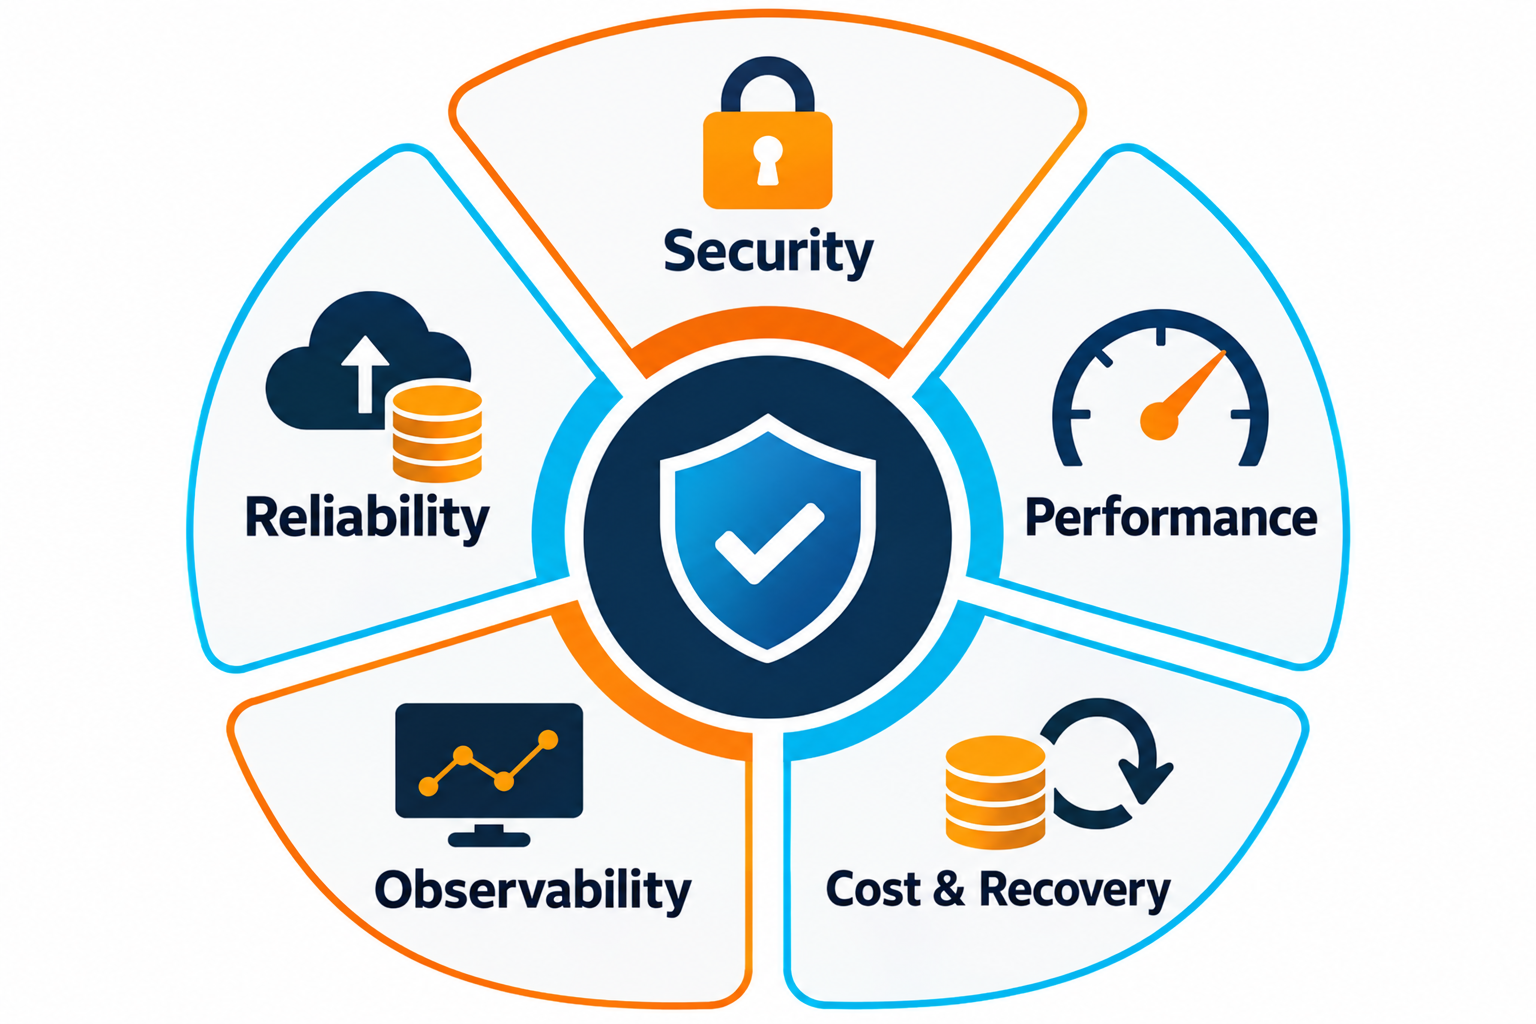
4. Observabilidad y operaciones
Los sistemas en producción necesitan suficiente evidencia para responder: ¿qué falló, dónde, para quién y desde cuándo? Revisa los logs de la aplicación, las métricas de CloudWatch, las alarmas, el tracing distribuido donde sea útil, los dashboards y los períodos de retención.
Una alarma debe conducir a una acción. El uso alto de CPU por sí solo puede no explicar una falla visible para el cliente; la latencia, la tasa de errores, el throttling, la antigüedad de la cola, las conexiones de base de datos y los errores de dependencias suelen dar mejor contexto.
5. Costo y recuperación
Estima la forma del costo, no solo la factura actual. Los NAT Gateways, el tráfico entre AZ, el logging de alto volumen, los recursos inactivos, las bases de datos sobredimensionadas y la retención agresiva pueden volverse significativos a medida que cambia el uso.
Luego define los objetivos de recuperación. El Recovery Time Objective (RTO) es qué tan rápido debe restaurarse el servicio; el Recovery Point Objective (RPO) es cuánta pérdida de datos es aceptable. La arquitectura, el calendario de backups y el proceso de recuperación deben soportar esos objetivos.
Un flujo de trabajo práctico antes de producción
Usa una secuencia de revisión corta en lugar de un cuestionario gigante:
- Dibuja la arquitectura desplegada a partir de los recursos reales de AWS.
- Traza las rutas críticas de solicitudes y eventos de extremo a extremo.
- Identifica exposición pública, límites de confianza y acceso privilegiado.
- Rompe conceptualmente una dependencia a la vez y documenta el comportamiento resultante.
- Verifica los límites de escalado desde el borde, pasando por el cómputo, hasta el almacenamiento.
- Verifica que los logs, métricas, alarmas, backups y procedimientos de restauración cubran las rutas críticas.
- Registra los hallazgos con severidad, recurso afectado, evidencia y una remediación concreta.
Ejemplo: una aplicación web que parece lista
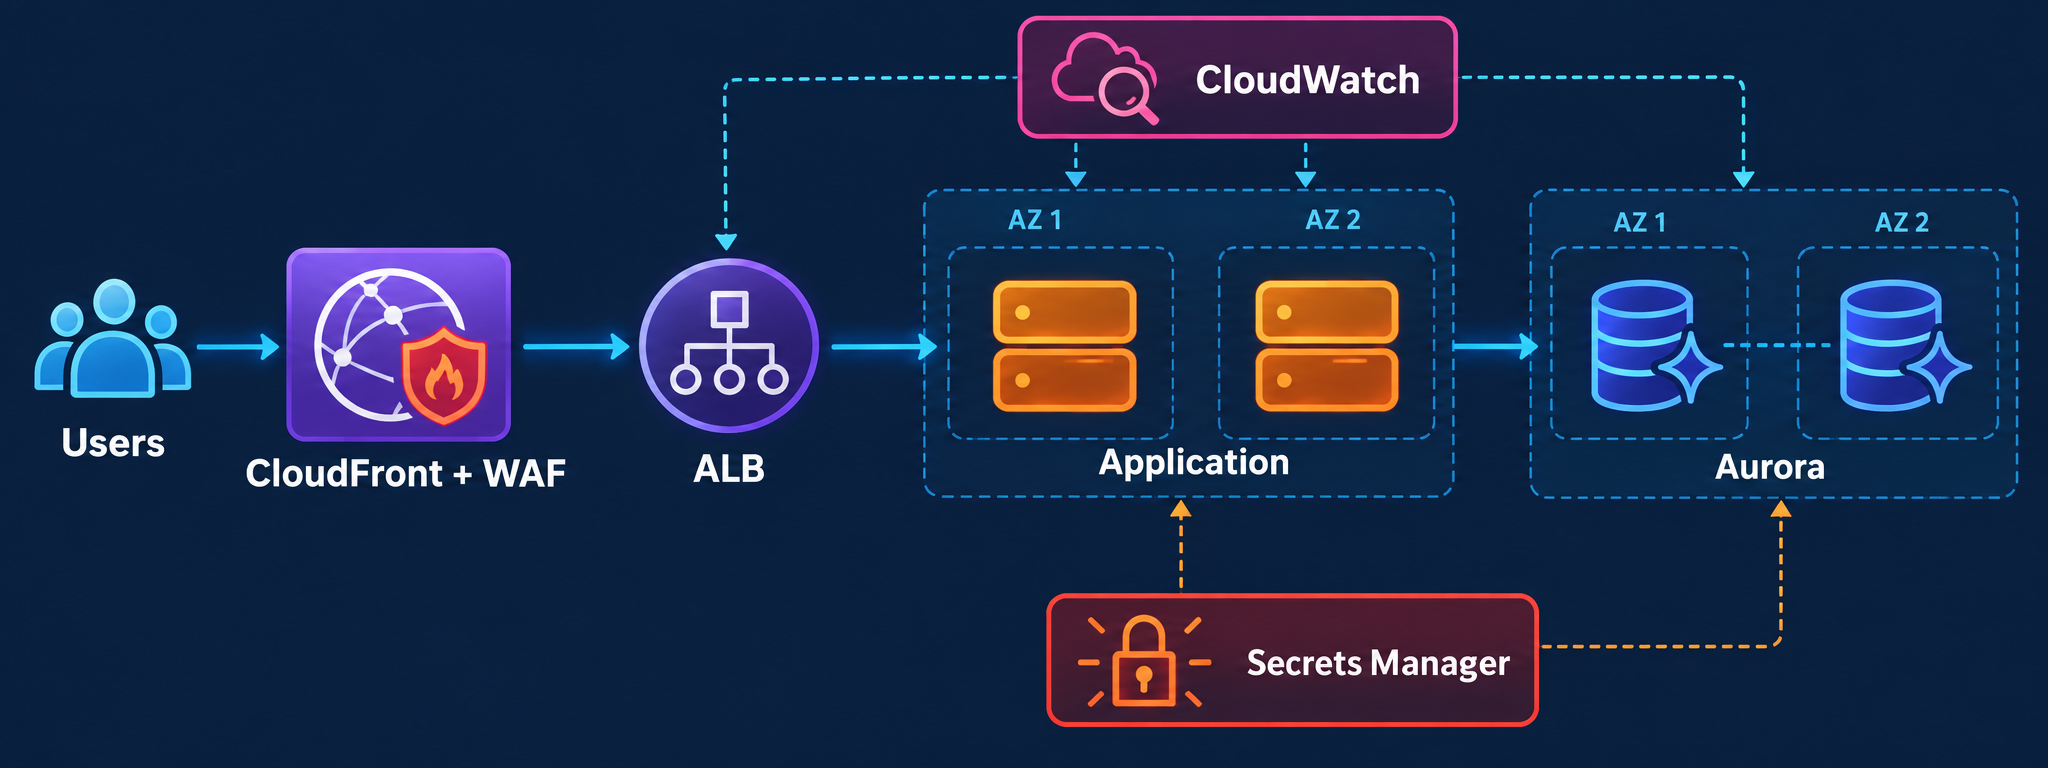
Considera CloudFront y AWS WAF delante de un Application Load Balancer, cómputo de la aplicación en dos zonas de disponibilidad, y Aurora detrás de todo. En el papel, el diseño se ve resiliente.
Una revisión aún podría encontrar que el security group de la aplicación acepta tráfico de más fuentes que el load balancer, que las credenciales de la base de datos están almacenadas en la configuración de la aplicación, que las alarmas cubren la CPU pero no los errores HTTP 5xx, y que existen backups de Aurora pero nadie ha probado una restauración.
Ninguno de esos hallazgos requiere rediseñar todo. Requieren cambios específicos: restringir las rutas de red, mover las credenciales a un secreto gestionado, alarmar sobre señales de falla visibles para el cliente, y probar la recuperación antes de que la producción dependa de ella.
Compensaciones y errores comunes
El objetivo no es la redundancia máxima en todas partes. El failover multi-región, las réplicas adicionales, una mayor retención de logs y más monitoreo agregan costo y complejidad operativa. Ajusta los controles al impacto de negocio y a los requisitos de recuperación.
El error común es tratar la revisión como un ejercicio de cumplimiento pasa/no pasa. Una revisión útil produce una lista priorizada: qué debe corregirse antes del lanzamiento, qué puede aceptarse temporalmente, quién es el responsable y cuándo se revisará de nuevo.
Antes de aprobar producción
Una revisión de producción es valiosa cuando convierte supuestos de arquitectura en comportamientos de falla explícitos, límites y acciones. Traza la carga de trabajo real, prioriza los hallazgos por impacto y probabilidad, y haz visible el riesgo no resuelto a las personas que aprueban el lanzamiento.
Si mantener esa imagen actualizada es la parte difícil, ArchNube.com está construido para eso. ArchNube Assess se conecta a través de un rol IAM estrecho, de solo lectura y controlado por el cliente, descubre los recursos de AWS soportados y aplica reglas deterministas para producir hallazgos de arquitectura explicables, sin acceso de escritura a la cuenta ni juicio de IA de caja negra.